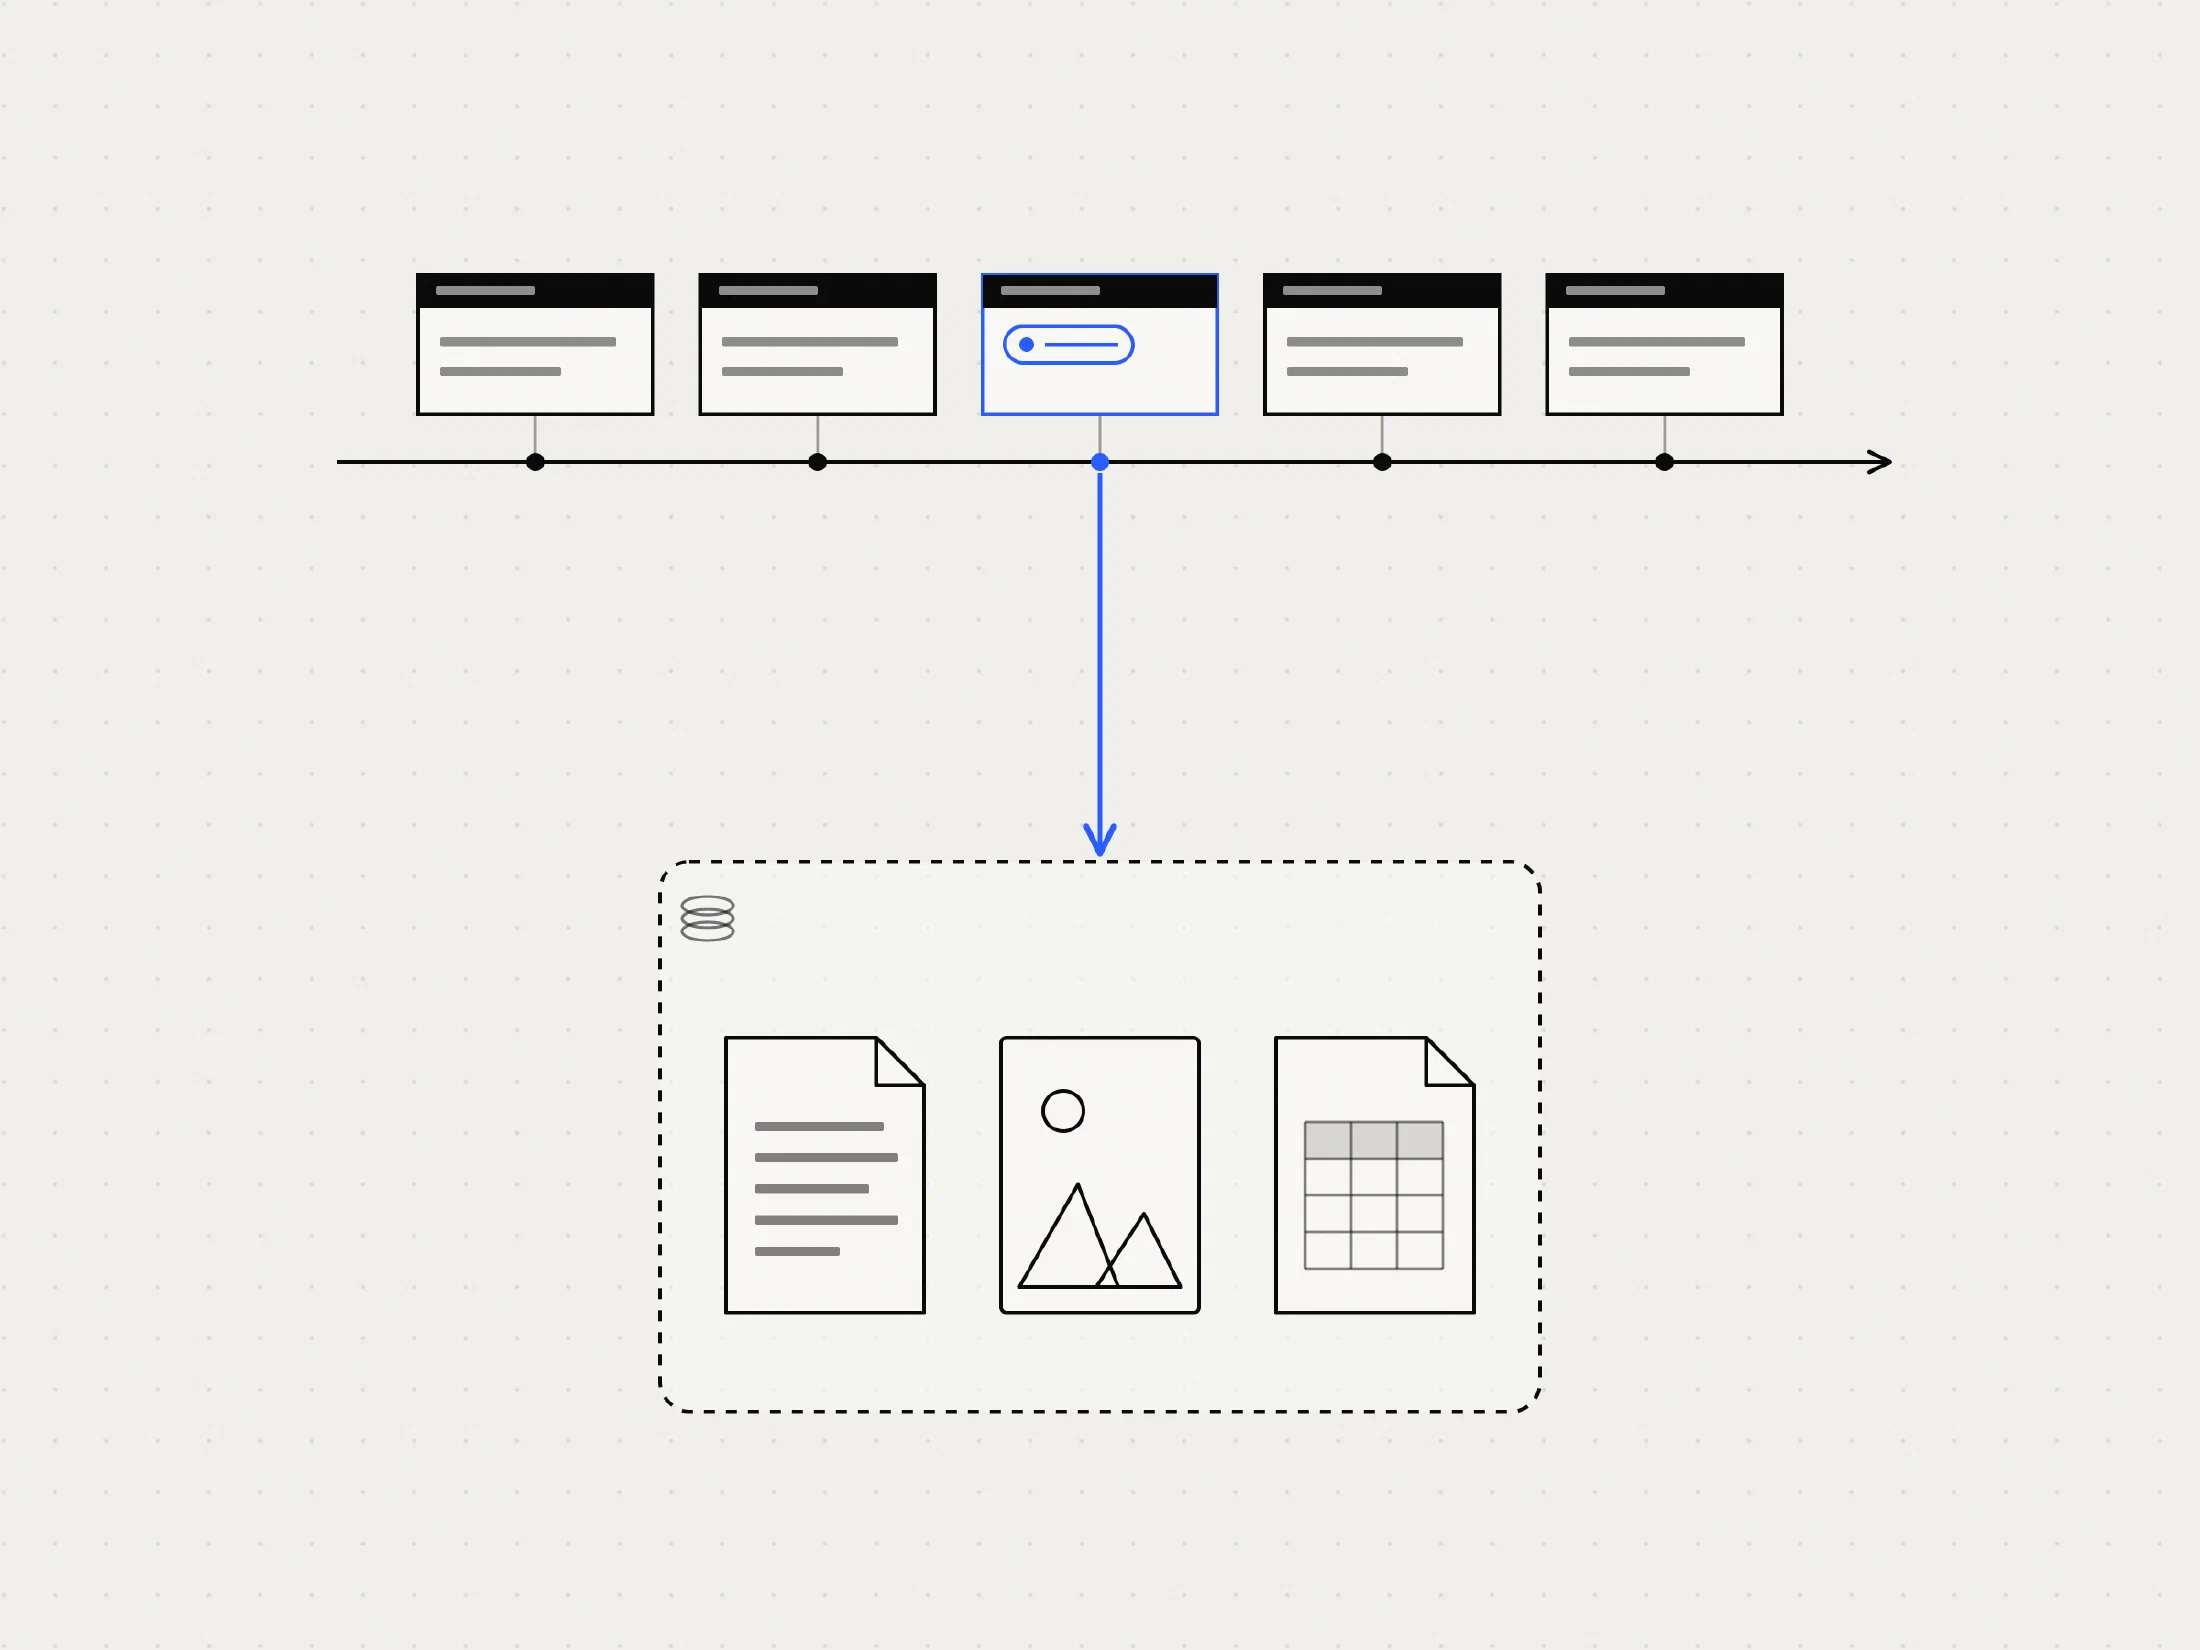
« Un candidat a téléversé un CV. » Un événement parfait : court, clair, un fait qui s’est produit.
Mais vient alors la question : où mettre le CV lui-même ? Le PDF de 8 Mo ?
La tentation est grande de le glisser directement dans l’événement. Tout au même endroit, bien simple. Mais en faisant cela, vous placez une bombe à retardement sous votre event store. Dans cet article, nous expliquons pourquoi fichiers volumineux et event sourcing font mauvais ménage quand vous les stockez dans l’événement lui-même, et comment nous résolvons le problème sans renoncer aux avantages de l’event sourcing.
Pourquoi les fichiers n’ont pas leur place dans votre event store
En event sourcing, votre event store est le journal de votre entreprise : chaque fait qui s’est jamais produit, bien rangé dans l’ordre. Ce journal est lu en permanence. Chaque règle métier qui vérifie quelque chose, chaque vue de synthèse qui se construit, lit des événements. Cette vitesse de lecture est le moteur de tout le système et, comme nous l’avons montré dans notre benchmark, c’est au final la base de données elle-même qui fixe la limite. Tout ce que vous faites traîner en plus à cette base, vous le payez donc directement en vitesse.
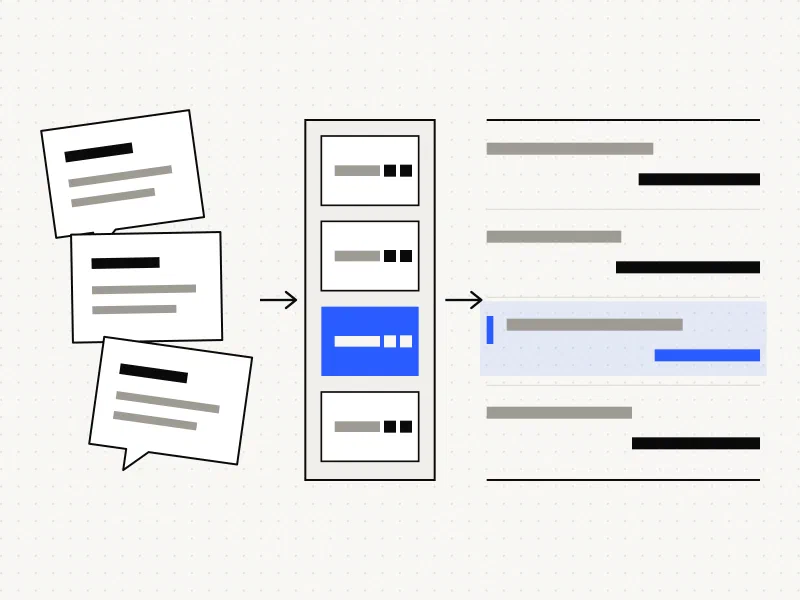
Si vous y glissez des fichiers volumineux, trois choses se produisent, et aucune n’est bonne :
Votre journal s’alourdit. Lire un événement d’un demi-kilo-octet est ultrarapide. Lire mille événements dont dix traînent un PDF de 8 Mo, ça ne l’est plus. Votre base de données charrie des mégaoctets pour un contrôle qui voulait seulement savoir si un CV avait été téléversé.
Tout devient plus cher. Vous ne supprimez jamais d’événements, donc chaque fichier stocké dans un événement y reste pour toujours. Votre base de données grossit, vos sauvegardes grossissent avec elle, et rejouer votre historique prend plus de temps à chaque téléversement.
Les bases de données ne sont pas faites pour ça. Les fichiers ont leur place dans un stockage de fichiers, conçu et tarifé pour cela. Une ligne de 8 Mo est une exception pénible pour n’importe quelle base de données.
Bref : un event store est fait pour des faits, pas pour des pièces jointes.
La solution : le fait dans le journal, le fichier à côté
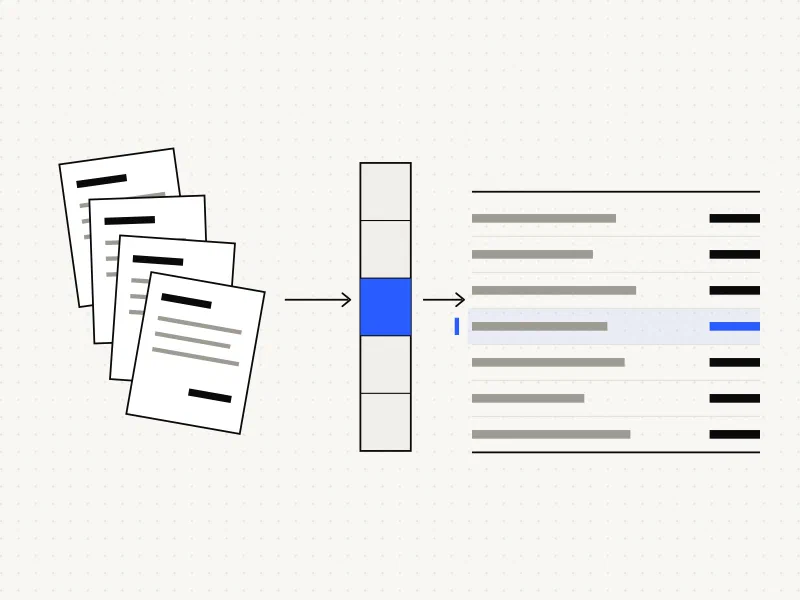
L’idée est simple. L’événement décrit ce qui s’est passé, le fichier lui-même part dans un espace de stockage séparé (un blob store, comme le stockage objet de votre fournisseur cloud). Dans l’événement ne reste qu’une petite référence.
Concrètement :
- Un événement arrive avec un champ volumineux, par exemple le contenu d’un CV.
- Avant que l’événement n’atterrisse dans le journal, ce champ en est extrait et stocké à part.
- Dans l’événement ne reste que la référence. L’événement lui-même est de nouveau léger.
- Quand l’événement est lu plus tard, le fichier est automatiquement récupéré avec lui. Pour le reste du logiciel, tout se passe comme s’il y avait toujours été.
Votre journal reste léger et rapide, et les fichiers sont là où ils doivent être.
L’effet secondaire bienvenu : tout n’a pas besoin de lire le fichier
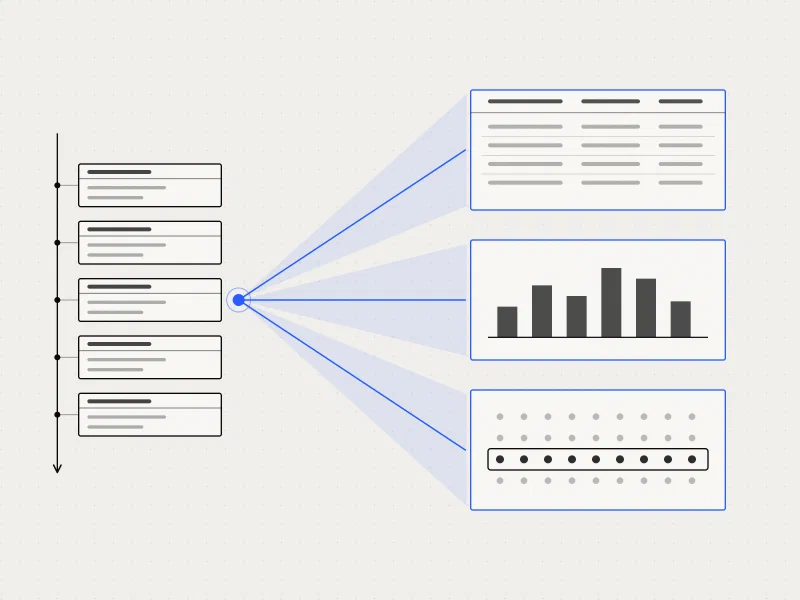
C’est là que ça devient vraiment intéressant. La plupart des parties de votre logiciel n’ont pas du tout besoin du fichier.
Prenez une vue de synthèse qui affiche combien de CV sont arrivés ce mois-ci. Elle doit seulement compter, pas lire. En ne récupérant le fichier que lorsque quelqu’un le demande vraiment (quand un recruteur ouvre le PDF, par exemple), toutes ces autres parties ne lisent que les petits événements. Le gain de vitesse est énorme, surtout quand il faut reconstruire des vues sur des années d’historique.
Et le RGPD ?
Les fichiers volumineux sont souvent justement ceux qui contiennent des données personnelles : CV, contrats, photos. Dans un article précédent, nous avons expliqué comment nous rendons effaçables les données personnelles contenues dans les événements grâce au crypto-shredding : jeter la clé plutôt que le coffre-fort.
Pour les fichiers, c’est encore plus simple. Ils ne se trouvent pas dans le journal immuable, mais à côté. En cas de demande d’effacement au titre du RGPD, ils peuvent donc tout simplement être réellement supprimés. L’événement reste en place en tant que fait (« un CV a été téléversé le 12 mars »), mais le fichier lui-même a disparu. Si un tel événement est relu plus tard, le système reconnaît que la pièce jointe a été supprimée et le gère proprement, au lieu de planter sur un fichier qui n’existe plus.
Les deux mécanismes fonctionnent ainsi ensemble : le crypto-shredding pour les données personnelles dans les événements, la suppression réelle pour les fichiers à côté. Une seule demande d’effacement, et les deux sont traités.
Notre approche
Dans notre framework, c’est intégré sous la forme d’une couche qui tourne automatiquement, comme le chiffrement. Quand vous écrivez un événement, vous indiquez quels champs sont des pièces jointes. Le reste se fait tout seul : stockage dans le blob store, référence dans l’événement, rechargement transparent à la lecture.
Le stockage lui-même est interchangeable. Stockage objet chez un fournisseur cloud européen, disque sur votre propre serveur : peu importe au framework. Cela correspond à notre façon de construire de toute manière : sur une infrastructure européenne, sans dépendance à un fournisseur, et avec des coûts de stockage qui correspondent à ce que vous stockez.
Le résultat : un event store qui reste rapide, des sauvegardes qui restent abordables, et des fichiers dont vous pouvez vraiment vous débarrasser en cas de demande d’effacement.
Précisons une chose, en toute honnêteté : ce n’est pas nécessaire dès le premier jour. Si vous n’avez que de petits événements, cette couche n’apporte rien. Mais dès que des fichiers entrent dans vos processus (documents, photos, scans), vous avez intérêt à bien la mettre en place dès le départ. Extraire après coup des fichiers d’un event store qui a grossi est un chantier pénible.
Vos processus contiennent des documents, des photos ou des scans, et vous voulez savoir si votre stockage tiendra dans la durée ? Parlez-nous-en, nous regarderons volontiers la question avec vous.