« D’accord, donc tout est dans ce journal. Mais comment j’obtiens simplement la liste de mes devis en cours ? »
C’est à peu près la première réaction de quiconque découvre l’event sourcing. Et c’est la bonne question, car un journal est formidable pour écrire et inutilisable pour chercher.
La réponse s’appelle une projection.
Qu’est-ce qu’une projection, exactement ?
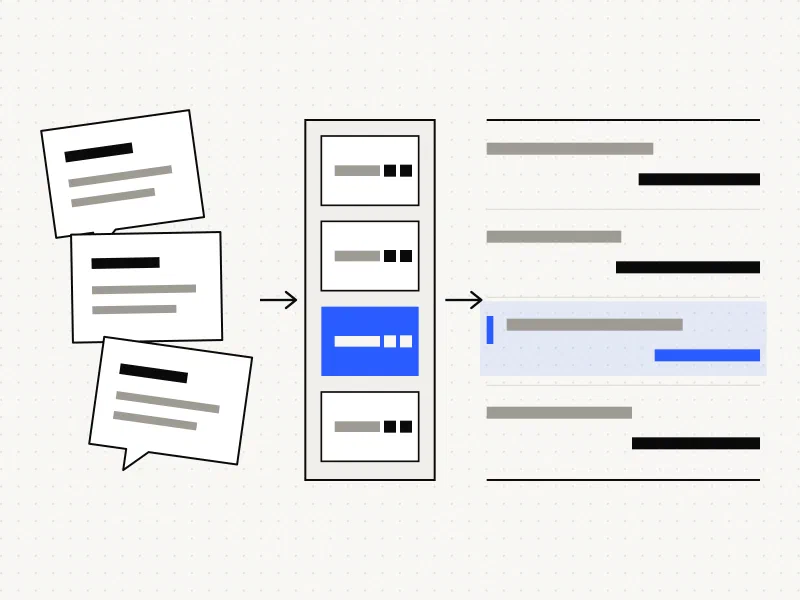
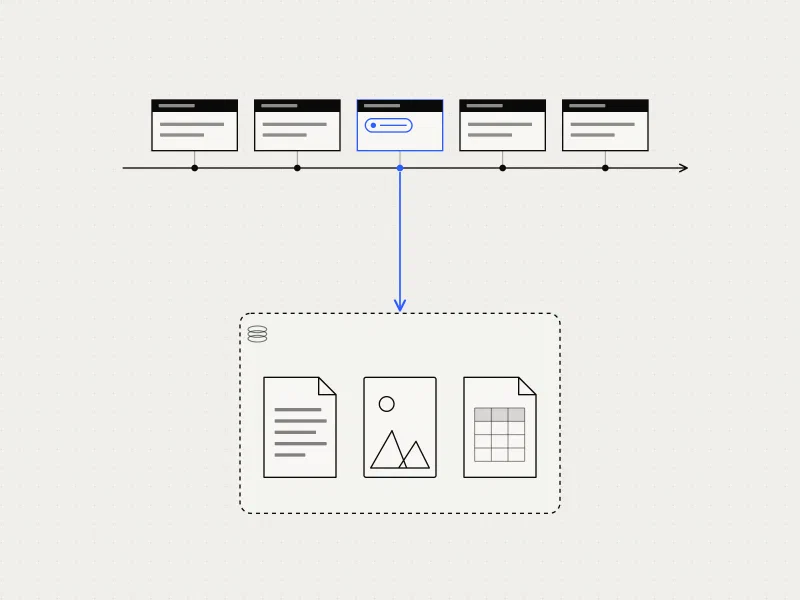
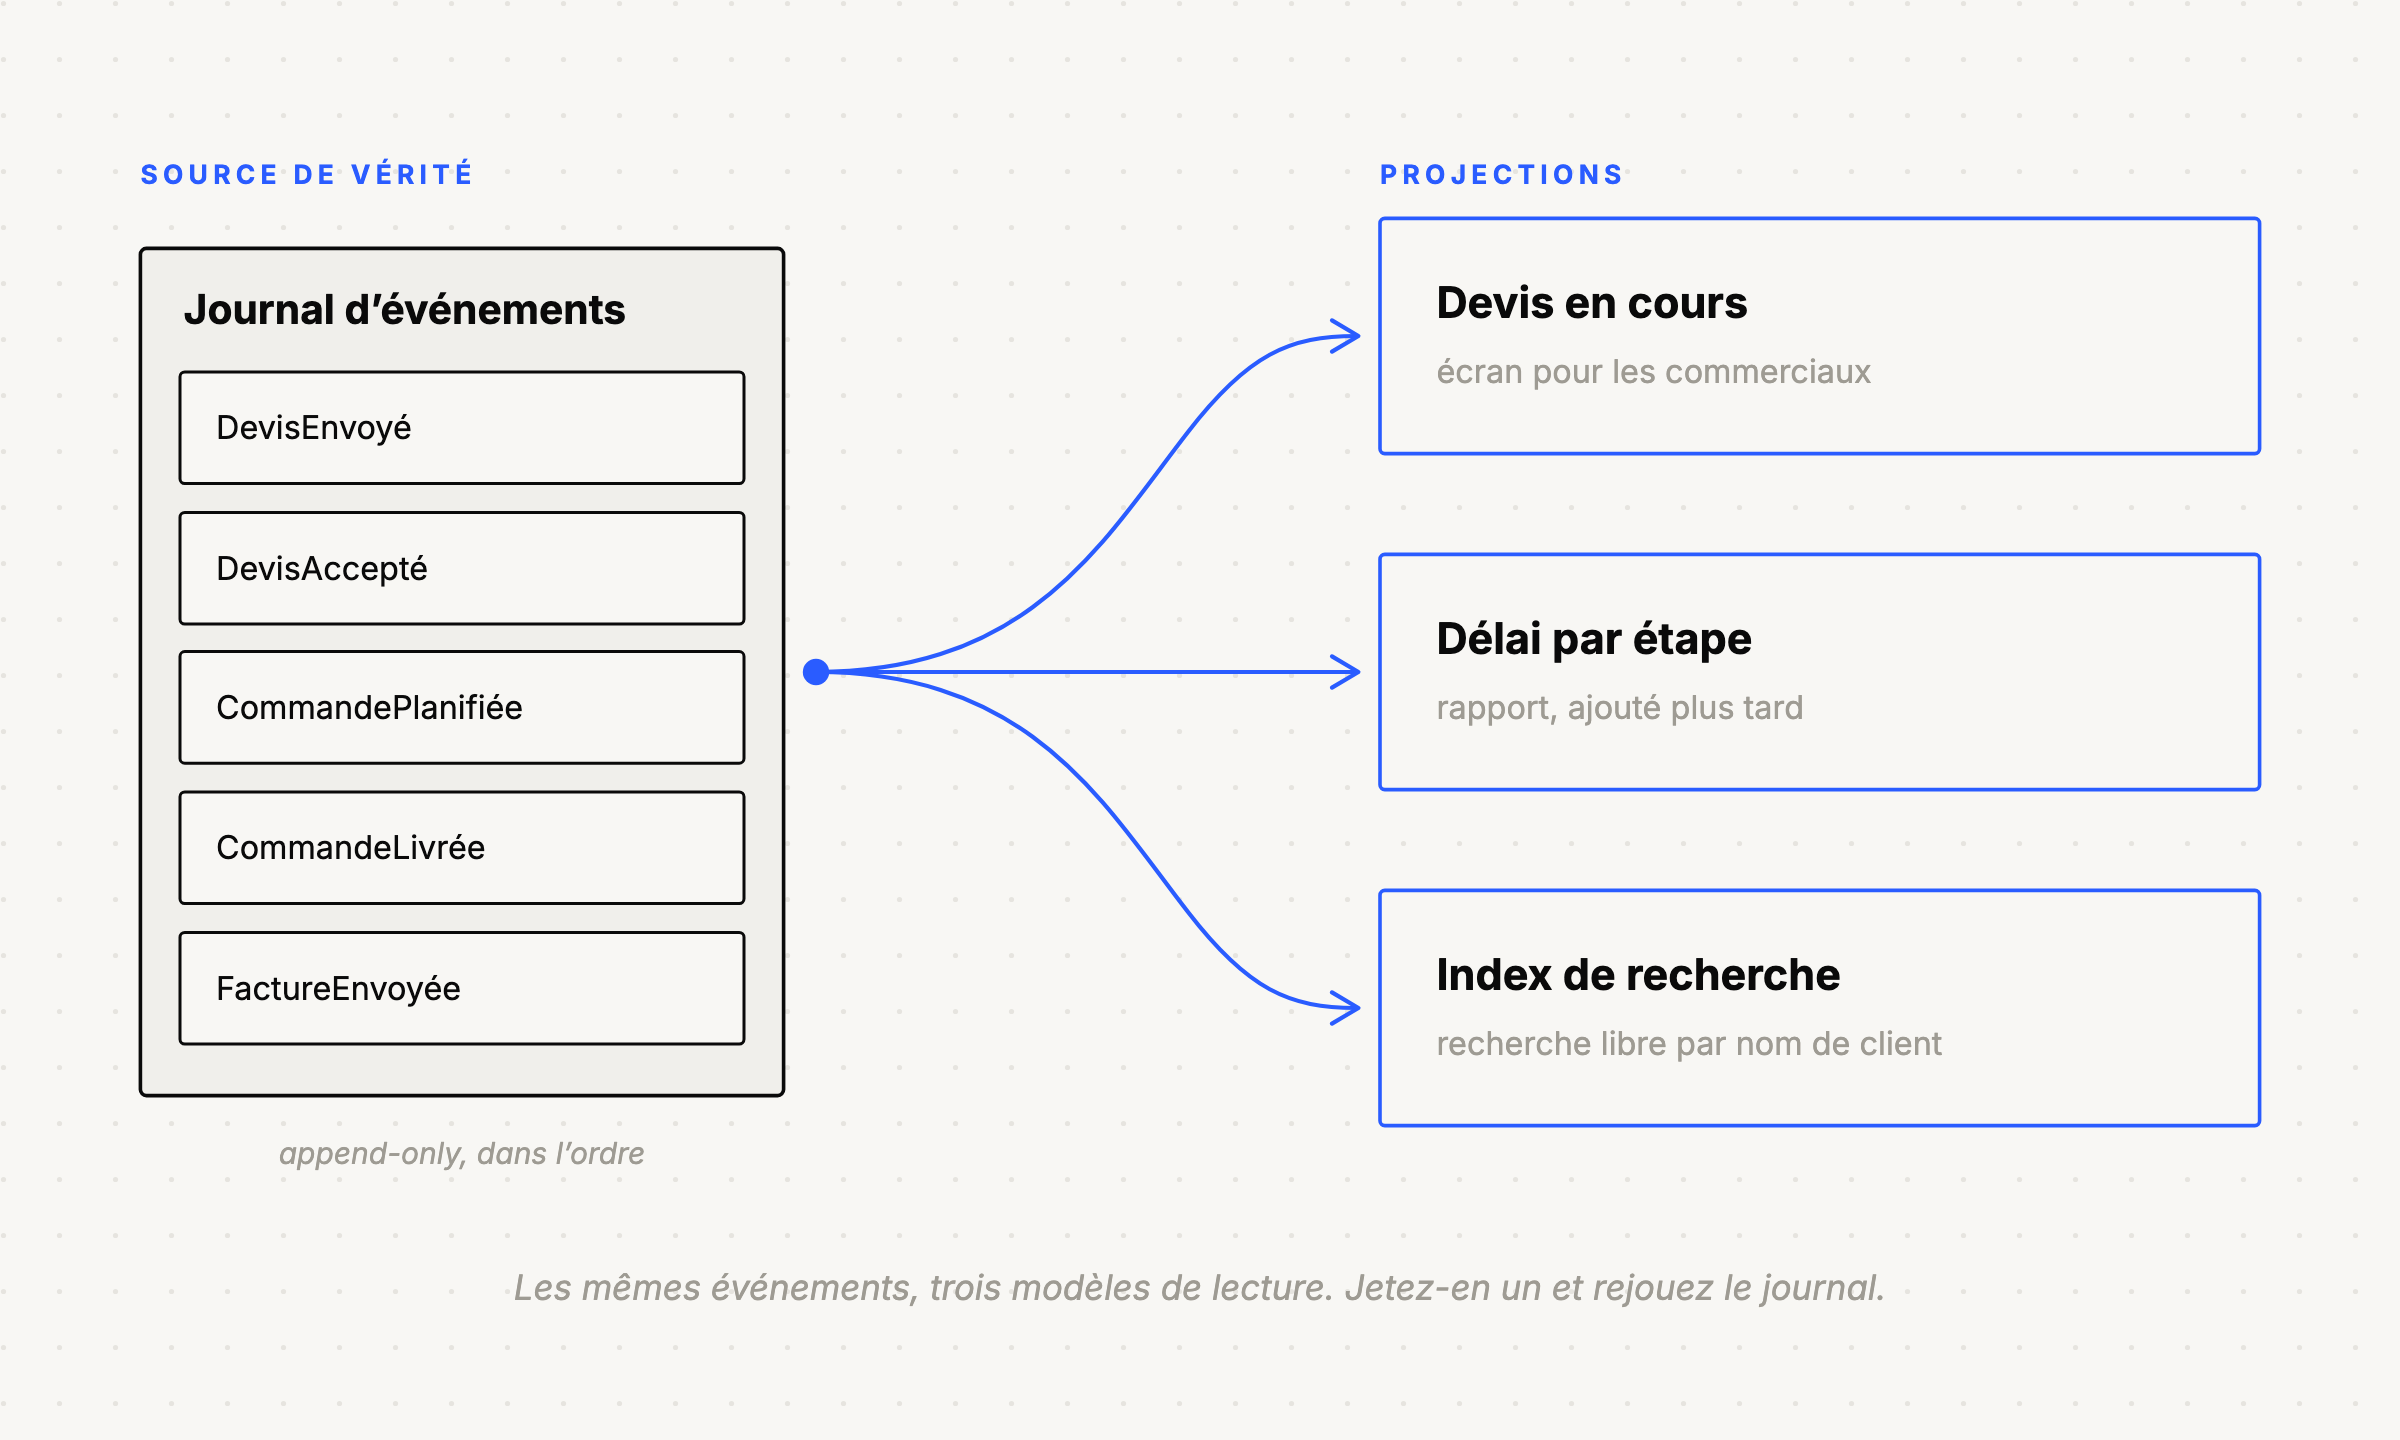
En event sourcing, la vérité est une suite de faits qui se sont réellement produits : DevisEnvoyé, DevisAccepté, CommandePlanifiée, CommandeLivrée. Ils sont ajoutés à la fin, dans l’ordre, et rien n’est jamais écrasé.
Si vous voulez savoir quels devis sont encore en cours aujourd’hui, vous ne pouvez pas simplement poser la question à cette suite. Il faudrait parcourir tout le journal, du début à la fin. À chaque fois.
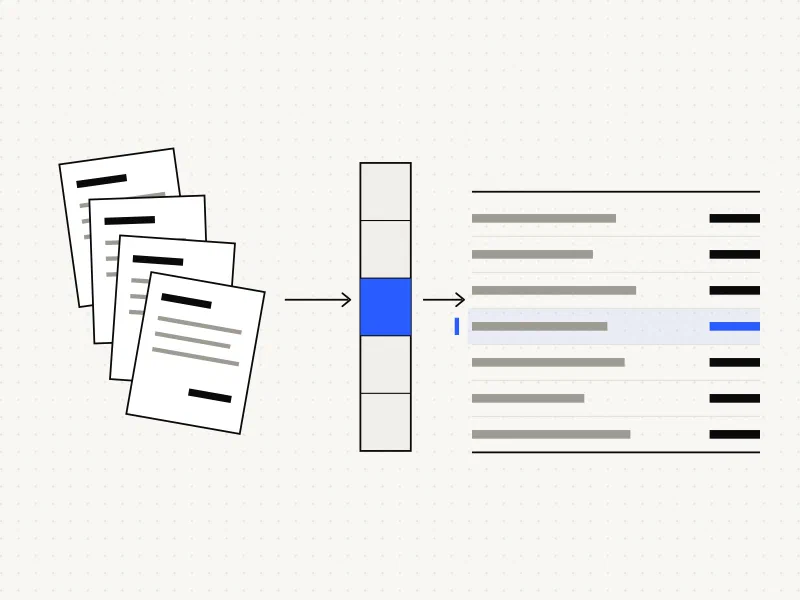
Alors vous le faites une seule fois. Vous parcourez les événements dans l’ordre en tenant une table à jour : à DevisEnvoyé, une ligne s’ajoute ; à DevisAccepté, elle disparaît. Ce qui reste est une table tout à fait ordinaire, que votre application lit en une seule requête.
Cette table, c’est la projection.
Deux propriétés font tout le travail.
Une projection est dérivée, jamais la vérité. Vous pouvez la jeter. Supprimez la table, rejouez le journal, et elle revient exactement comme elle était. Ça a l’air d’un détail, mais ça change tout dans la façon dont vous gérez les erreurs.
Vous pouvez en avoir autant que vous avez de questions. Les mêmes événements alimentent votre écran des devis, votre rapport sur les délais et votre index de recherche. Chacun sous la forme qui répond le plus vite à cette question précise. Plus aucun schéma n’a à être un compromis entre ce que le commercial veut voir sur son écran et ce que le dirigeant veut dans son rapport.
Est-ce propre à l’event sourcing ?
Non. Et c’est important de le savoir avant de vous lancer.
L’idée d’« une forme de lecture dérivée au-dessus d’une source de vérité » est partout :
- Une vue matérialisée dans PostgreSQL repose exactement sur le même principe, simplement au-dessus de tables plutôt que d’événements.
- Un index de recherche dans Elasticsearch, que vous gardez synchronisé avec votre base de données.
- Une table de reporting mise à jour pendant la nuit.
- Même votre comptabilité : un bilan n’est rien d’autre qu’une projection de votre grand livre.
Les projections relèvent, à strictement parler, du CQRS, et le CQRS fonctionne très bien sans event sourcing.
Ce que l’event sourcing change, en revanche, c’est que la source est complète. Dans une base de données classique, chaque UPDATE a détruit la valeur précédente. Votre vue matérialisée ne peut donc projeter que ce que vos tables actuelles conservent encore. Avec un journal d’événements, vous construisez une projection pour une question que personne ne se posait quand ces événements ont été écrits.
Tout le gain est là.
Qu’est-ce que ça vous apporte ?
De nouvelles questions sur d’anciennes données. En mars, votre dirigeant demande : « au fond, combien de temps nos devis restent-ils en attente ? » Si vous ne conservez que le statut actuel, la réponse est « je le saurai à partir d’aujourd’hui, revenez en septembre ». Avec un journal d’événements, vous écrivez une nouvelle projection, elle rejoue l’historique, et vous avez la réponse sur les trois dernières années.
Les erreurs coûtent peu. Un bug dans la logique de votre rapport, ou une structure à revoir ? Corriger le code, jeter la table, rejouer. Pas de scripts de migration, pas d’archéologie dans des données corrompues.
Lecture et écriture se séparent. Le côté écriture garde vos règles métier. Chaque côté lecture est taillé pour une seule question. Les deux n’ont plus besoin de tenir dans le même schéma.
Et la vitesse ?
C’est là que se cache le plus gros malentendu. « Donc ces rapports lents, c’est réglé ? » En partie.
La requête de lecture devient en effet beaucoup plus rapide. Une jointure sur sept tables, avec quelques fonctions de fenêtrage par-dessus, devient une simple lecture dans une table qui a exactement la forme de cet écran. Plus important encore : la vitesse devient prévisible. Elle ne se dégrade plus à mesure que votre base grossit, car le plan d’exécution ne change plus de forme.
Mais le calcul n’a pas disparu. Il est passé du moment de la lecture au moment de l’écriture. Vous le payez désormais une fois par événement, au lieu d’une fois par question.
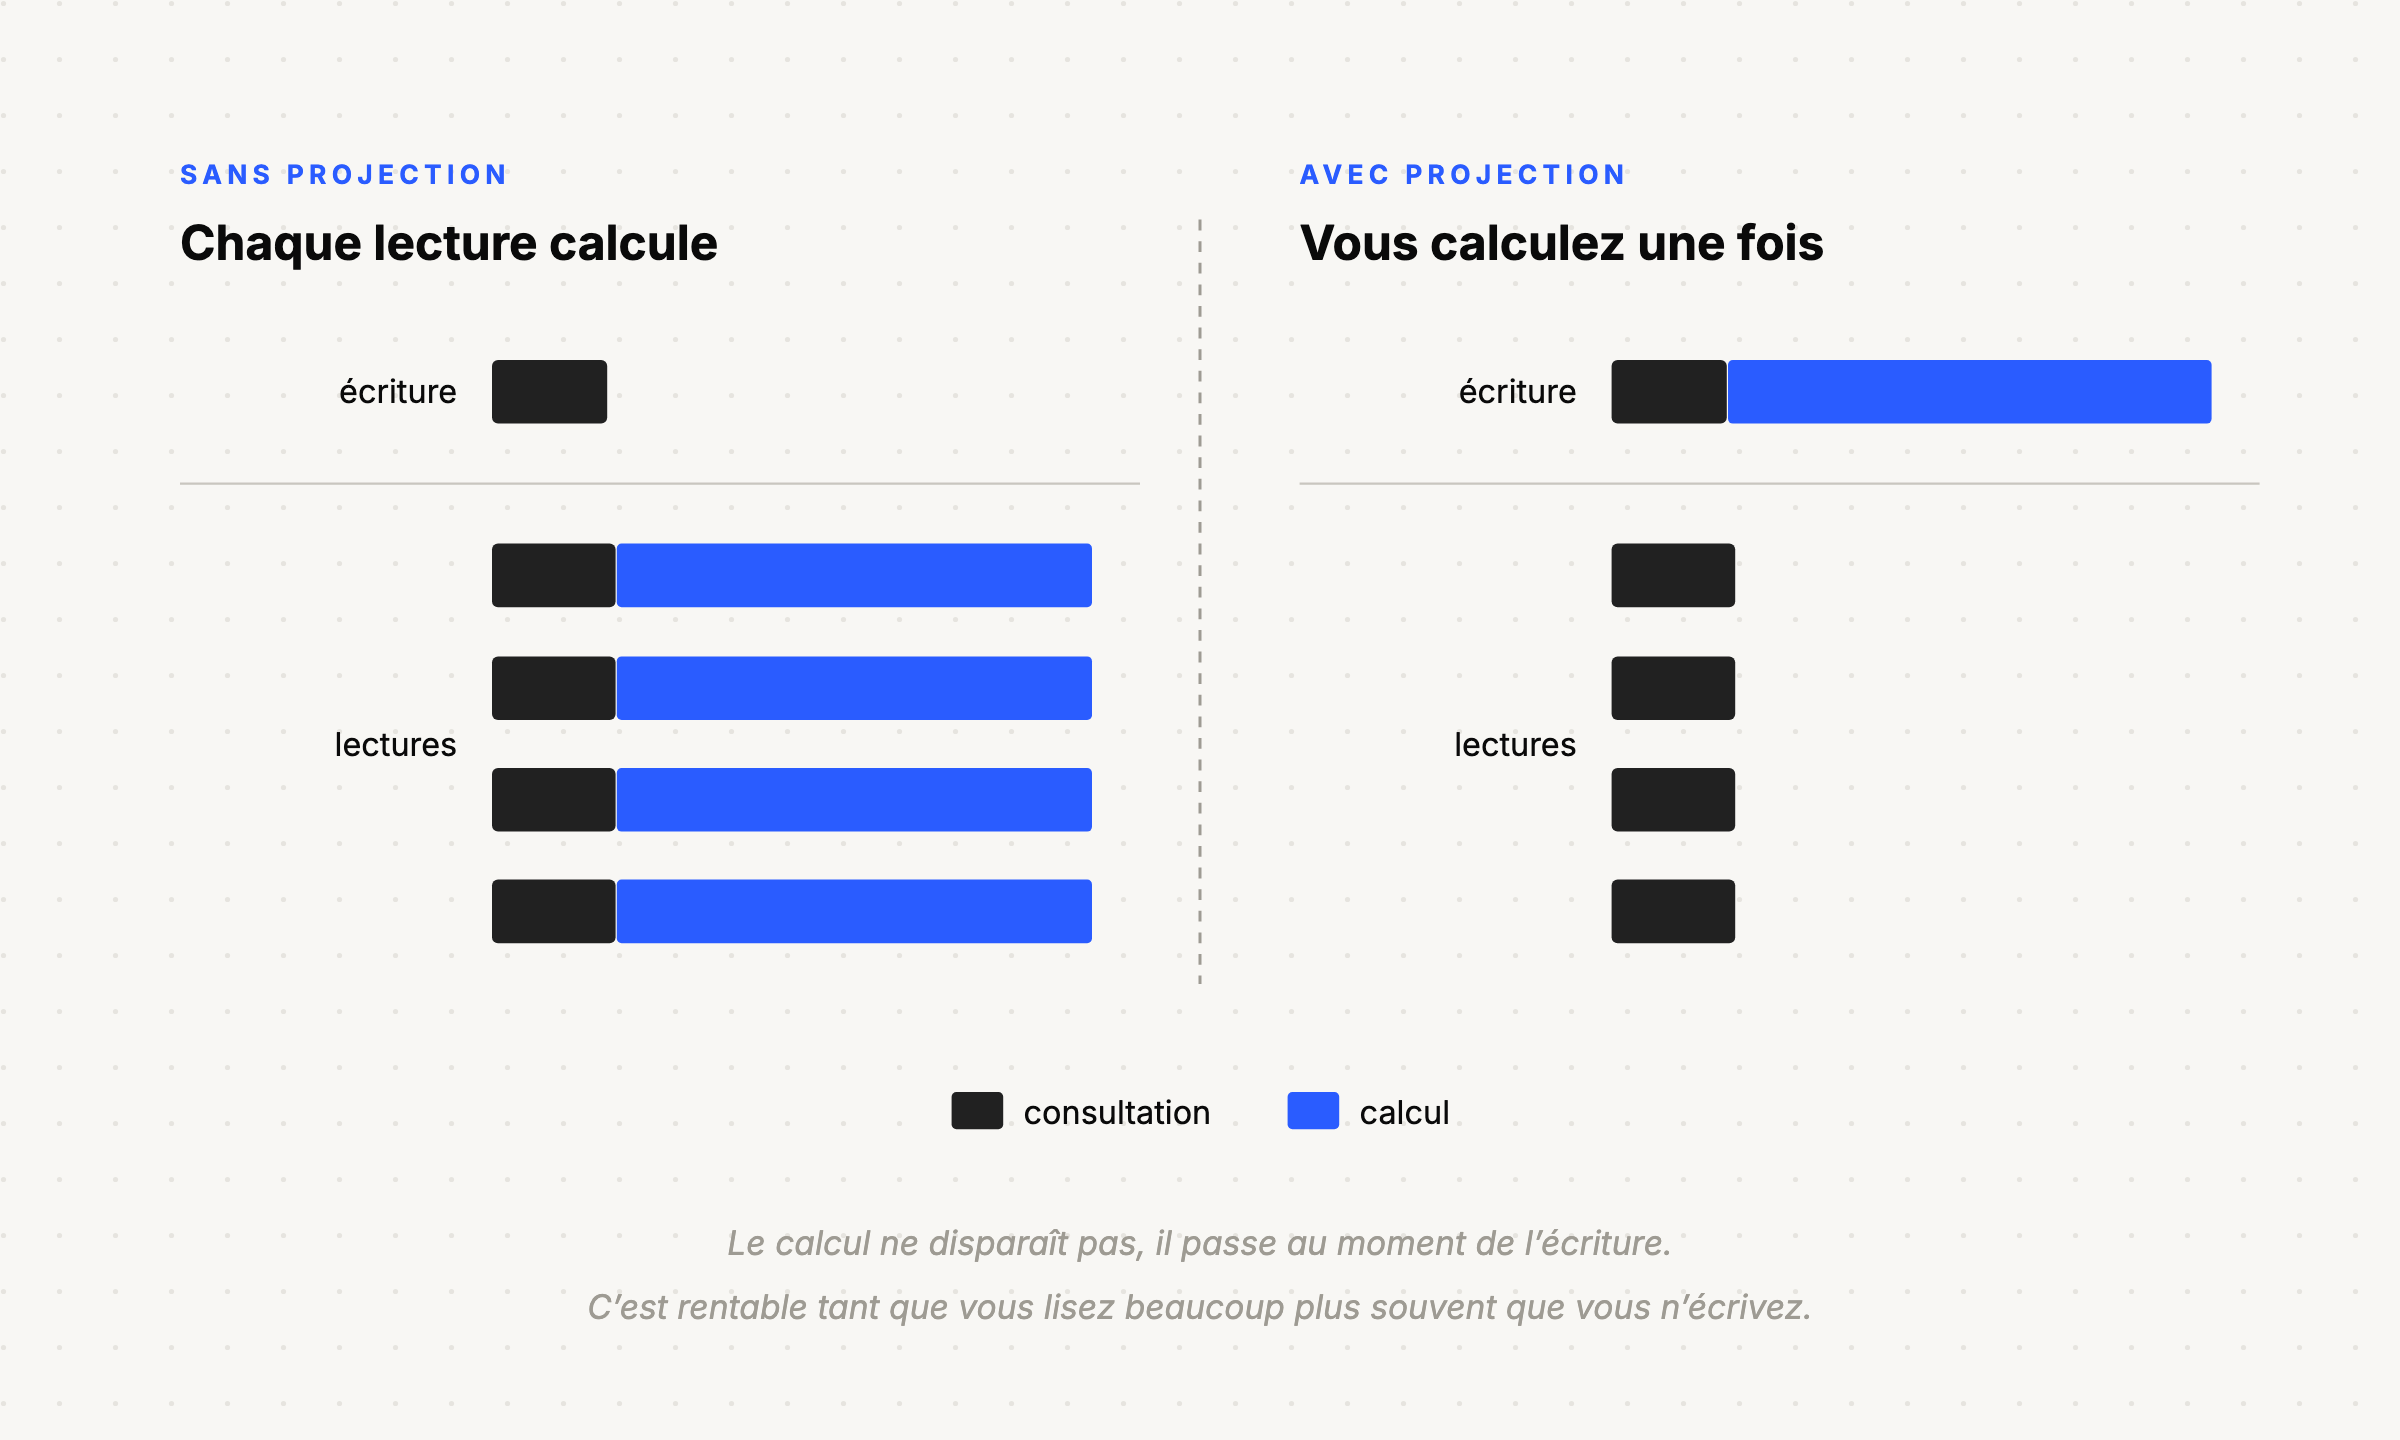
Cet échange est excellent tant que vous lisez beaucoup plus souvent que vous n’écrivez. Un écran de synthèse qui se charge à chaque affichage de page : parfait. Mais un rapport lancé douze fois par an, que vous devez tenir à jour en continu sur des millions d’événements : mauvaise affaire. Lancez simplement cette requête lente douze fois.
Et notez bien ce qu’une projection ne résout pas : les questions ad hoc. Une projection est une réponse calculée d’avance à une question connue. Si quelqu’un branche un outil de BI sur vos données pour des requêtes libres, il vous faut toujours une base de données classique interrogeable, ou un entrepôt de données.
Elle ne règle pas non plus une requête qui est lente simplement parce qu’il manque un index.
Les pièges
Le décalage. Si vous mettez vos projections à jour de façon asynchrone, quelqu’un peut enregistrer quelque chose et ne pas encore le voir apparaître. Ce n’est pas un détail que vous corrigerez plus tard : ça touche chaque écran de votre application. Il vous faut une réponse, et cette réponse demande du travail.
Le versionnage de vos événements. Un événement que vous écrivez aujourd’hui doit encore être compréhensible dans cinq ans par le code qui existera alors. Ça demande de la discipline : soit vous traduisez les anciens événements à la lecture, soit vous écrivez des lecteurs qui supportent les champs manquants.
Le temps de reconstruction grandit avec le journal. « Rejouez simplement le journal » est une belle propriété à cent mille événements, et un problème de planification à cinquante millions. Il vous faut alors des snapshots, ou vous construisez la nouvelle version à côté de l’ancienne et ne basculez qu’une fois qu’elle a rattrapé son retard.
Le même événement passe deux fois. Avec presque toutes les façons de mettre à jour, ça arrive tôt ou tard. Chaque projection doit le supporter, sinon vous comptez votre chiffre d’affaires en double.
Notre approche
Nous ne commençons pas par l’event sourcing. Si le problème concret est « cet écran met huit secondes à se charger », nous allons du moins cher au plus cher : d’abord regarder le plan d’exécution et ajouter l’index manquant, puis réécrire la requête, puis une vue matérialisée avec une stratégie de rafraîchissement. Cette dernière étape représente un après-midi de travail et, en pratique, fait disparaître l’essentiel de la lenteur.
Nous utilisons l’event sourcing quand l’historique fait vraiment partie du domaine. Suivi des devis, suivi de dossiers, comptabilité : tout ce où « que s’est-il passé exactement, et quand ? » est une vraie question. La vitesse de vos projections est alors un bonus appréciable, pas un argument en soi.
Ce à quoi nous tenons :
- Chaque projection peut être reconstruite, et nous testons cette reconstruction. Une projection que vous n’osez pas jeter en pratique n’est plus une projection.
- Chaque projection garde sa propre position, pour pouvoir prendre du retard ou être reconstruite séparément sans toucher au reste.
- Nous disons à l’avance où vous verrez le décalage à l’écran, et comment nous le gérons. Mieux vaut une conversation désagréable au départ qu’une surprise à la livraison.
- Tout tourne sur des serveurs européens, sans dépendance à un fournisseur, et vous restez propriétaire du code, des données et de l’infrastructure.
Vous voulez savoir comment nous gardons aussi vos règles métier cohérentes avec ce même modèle ? Lisez Qu’est-ce que le DCB (Dynamic Consistency Boundary) ?. Et nous avons montré avec un benchmark que tout cela reste rapide et abordable sur une infrastructure européenne ordinaire.
Vous êtes coincé sur un rapport qui ralentit chaque mois, ou sur une question à laquelle vos données ne savent pas répondre ? Parlez-nous-en, nous regarderons volontiers avec vous où ça bloque.