« Pouvez-vous supprimer mes données ? »
Pour la plupart des logiciels, c’est une question simple. Vous cherchez la ligne dans la base de données, vous cliquez sur supprimer, terminé. Mais en event sourcing, c’est différent. Toute l’architecture repose sur un principe : on ne supprime jamais rien. Chaque événement est un fait qui s’est produit, et les faits, on ne les efface pas.
Cela entre de plein fouet en collision avec le RGPD. Le droit à l’effacement, ou « droit à l’oubli », permet à une personne d’exiger que vous effaciez ses données personnelles. Pas que vous les archiviez, pas que vous les cachiez : que vous les effaciez vraiment.
Deux règles qui se regardent droit dans les yeux. Comment s’en sortir ?
Pourquoi ne pas simplement supprimer les événements
Vous pourriez vous dire : supprimons donc ces événements. Mais vous casseriez alors précisément ce qui fait la valeur de l’event sourcing.
Un event store est le journal de votre entreprise. Chaque devis envoyé, chaque validation, chaque modification y figure, dans l’ordre. D’autres événements y font référence. Vos vues dérivées (les projections) sont construites à partir de lui. Si vous retirez des événements au milieu, votre historique ne tient plus, et vous risquez que le reste de votre système repose sur du sable.
De plus, souvent, vous ne voulez pas du tout tout perdre. Qu’un candidat ait postulé le 12 mars est un fait dont vos statistiques et votre piste d’audit ont besoin. Qui était ce candidat : voilà ce qui doit disparaître.
Crypto-shredding : jeter la clé plutôt que le coffre-fort
La solution s’appelle le crypto-shredding, et l’idée est étonnamment simple.
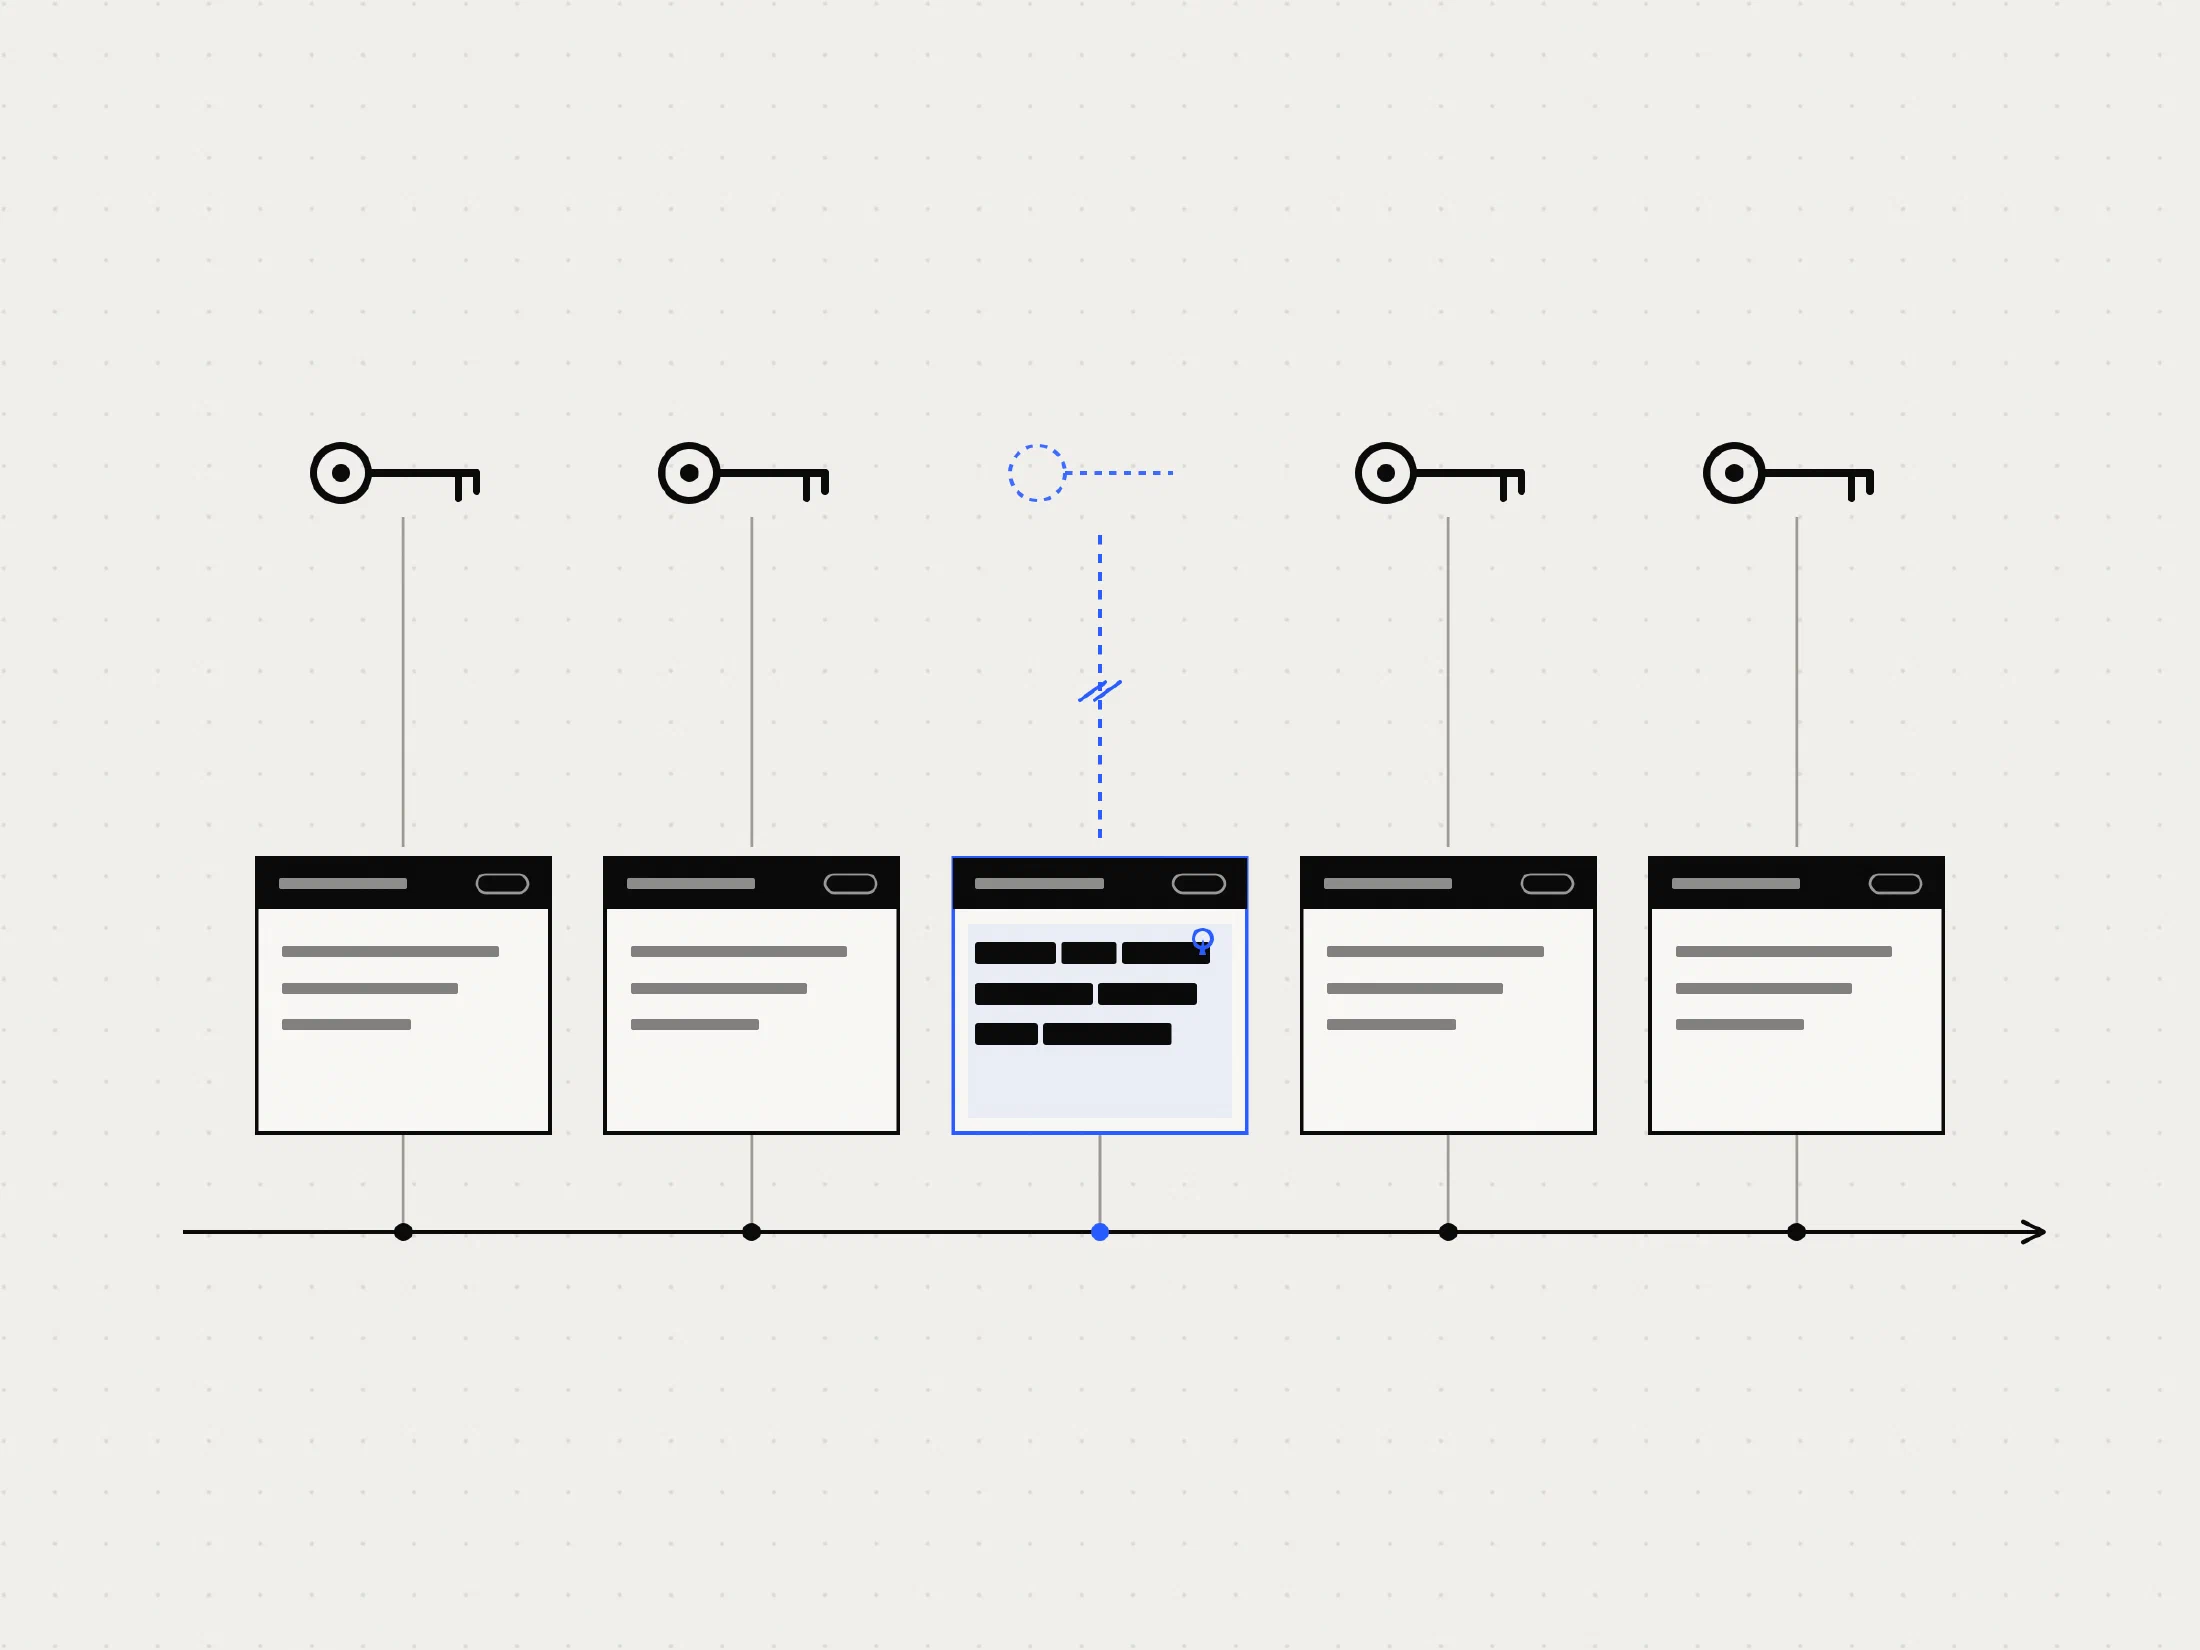
Imaginez que vous rangiez toutes les données personnelles d’une personne dans un coffre-fort. Le coffre reste là où il est, mais sans la clé, personne ne peut l’ouvrir. Vous voulez oublier cette personne ? Vous ne jetez pas le coffre, mais la clé.
Transposé au logiciel :
- Chaque personne reçoit sa propre clé de chiffrement.
- Les données personnelles contenues dans les événements sont chiffrées avec cette clé avant d’arriver dans l’event store.
- À la lecture, elles sont automatiquement déchiffrées. Personne ne s’en aperçoit.
- Quelqu’un demande à être oublié ? Vous supprimez la clé. Une seule suppression, et tous les événements de cette personne sont définitivement illisibles.
Les événements eux-mêmes restent en place. Le type, l’ordre, les horodatages : tout reste intact. Seul le contenu a disparu pour de bon. Votre historique tient toujours, vos statistiques aussi, mais la personne est réellement oubliée.
Pas besoin de tout mettre sous clé
Un raffinement qui fait une grande différence : vous n’avez pas besoin de chiffrer tout l’événement. Souvent, un événement ne contient que quelques champs de données personnelles.
Prenez un événement comme « candidat créé ». Le nom et l’adresse e-mail sont des données personnelles, mais l’intitulé du poste et la date ne le sont pas. Si vous ne chiffrez que ces champs sensibles, le reste de l’événement reste lisible, même après l’oubli. Votre reporting sur le nombre de candidats arrivés chaque mois continue de fonctionner, alors que les noms et les adresses e-mail ont disparu.
Les pièges à surveiller
Le crypto-shredding a l’air élégant, et il l’est. Mais certaines choses doivent être bien faites, sinon ce n’est qu’une illusion de sécurité.
Vos clés doivent pouvoir disparaître pour de vrai. Ça paraît logique, mais beaucoup de systèmes pratiquent la suppression logique (soft delete) : les lignes supprimées continuent d’exister en douce, avec un simple indicateur. Pour des clés de chiffrement, c’est fatal. Supprimé doit vouloir dire supprimé, y compris dans les sauvegardes de votre stockage de clés.
Vos données dérivées doivent suivre. Chiffrer les événements ne suffit pas si vos projections, vos index de recherche et vos caches conservent ces mêmes données personnelles en clair. Lors de l’oubli, ces données dérivées doivent elles aussi être nettoyées.
Les métadonnées aussi peuvent trahir. Si vos événements sont taggés avec une adresse e-mail comme identifiant, il reste une donnée personnelle dans votre journal, même après le shredding. Utilisez des identifiants anonymes comme tags, jamais les données elles-mêmes.
Les données partagées demandent un choix. Un message échangé entre deux personnes appartient aux deux. Que se passe-t-il si l’une d’elles veut être oubliée ? Il faut y réfléchir à l’avance, pas au moment où la demande arrive.
Notre approche
Chez Tandem Studio, nous construisons sur l’event sourcing, et le crypto-shredding est intégré par défaut dans notre framework. Pas comme un ajout après coup, mais comme une couche qui tourne automatiquement.
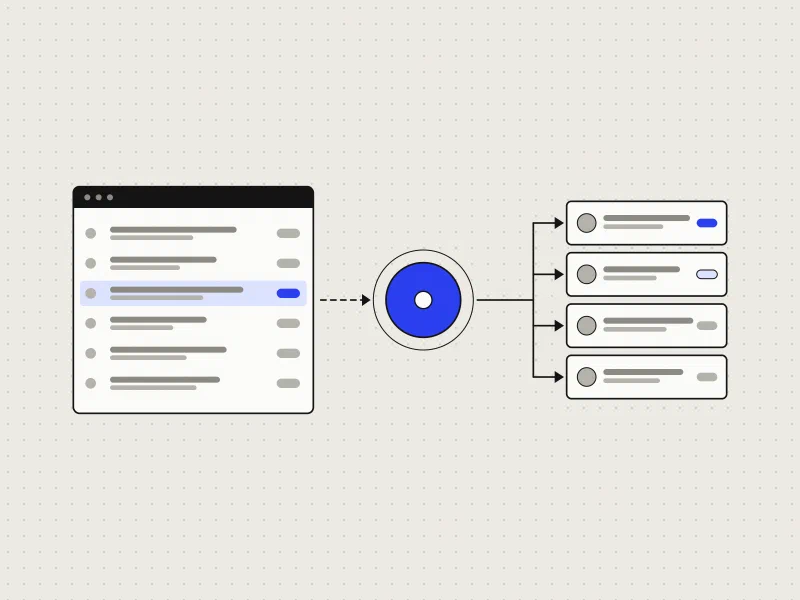
Quand vous écrivez un événement, vous indiquez quel tag identifie la personne et quels champs contiennent des données personnelles. Le framework chiffre lui-même ces champs, avec une clé propre à chaque personne. À la lecture, tout est déchiffré de façon transparente. Le reste de l’application n’en sait rien.
Quelqu’un veut être oublié ? Deux choses se passent alors. D’abord, nous écrivons un événement métier ordinaire, pour que les vues de synthèse et les index de recherche fassent aussitôt disparaître la personne. Ensuite, nous supprimons la clé, définitivement. À partir de ce moment, tous les anciens événements de cette personne sont illisibles, même si vous rejouez l’historique plus tard. Le système reconnaît les données supprimées et les ignore proprement.
Les données partagées sont couvertes elles aussi : si l’une des personnes concernées est oubliée, la clé partagée part également à la poubelle.
Vous obtenez ainsi le meilleur des deux mondes. Un journal complet et fiable de votre entreprise, et la certitude qu’une demande d’effacement efface vraiment quelque chose.
Pourquoi nous choisissons l’event sourcing de toute façon, vous le lirez dans L’event sourcing pour les logiciels de PME. Comment nous imposons aussi des règles métier cohérentes avec ce même modèle (et pourquoi les tags y jouent un rôle important), nous l’expliquons dans Qu’est-ce que le DCB (Dynamic Consistency Boundary) ?. Et nous avons montré, avec un benchmark sur une infrastructure européenne ordinaire, que tout cela reste rapide et abordable.
Vous traitez des données personnelles et vous voulez savoir si votre logiciel peut vraiment faire face à une demande d’effacement ? Parlez-nous-en, nous regarderons volontiers la question avec vous.