Le « vibe coding » comme façon de programmer, enchaîner les prompts et accepter ce qui en sort, a suscité en un temps record un contre-courant : le spec-driven development. D’abord écrire ce que vous voulez, et seulement ensuite laisser l’IA construire. Cela ressemble étrangement au model-driven development dont nous avons déjà parlé. Pourtant, ce ne sont pas des synonymes. Et le plus intéressant se trouve justement dans la combinaison des deux.
Qu’est-ce que le model-driven development ?
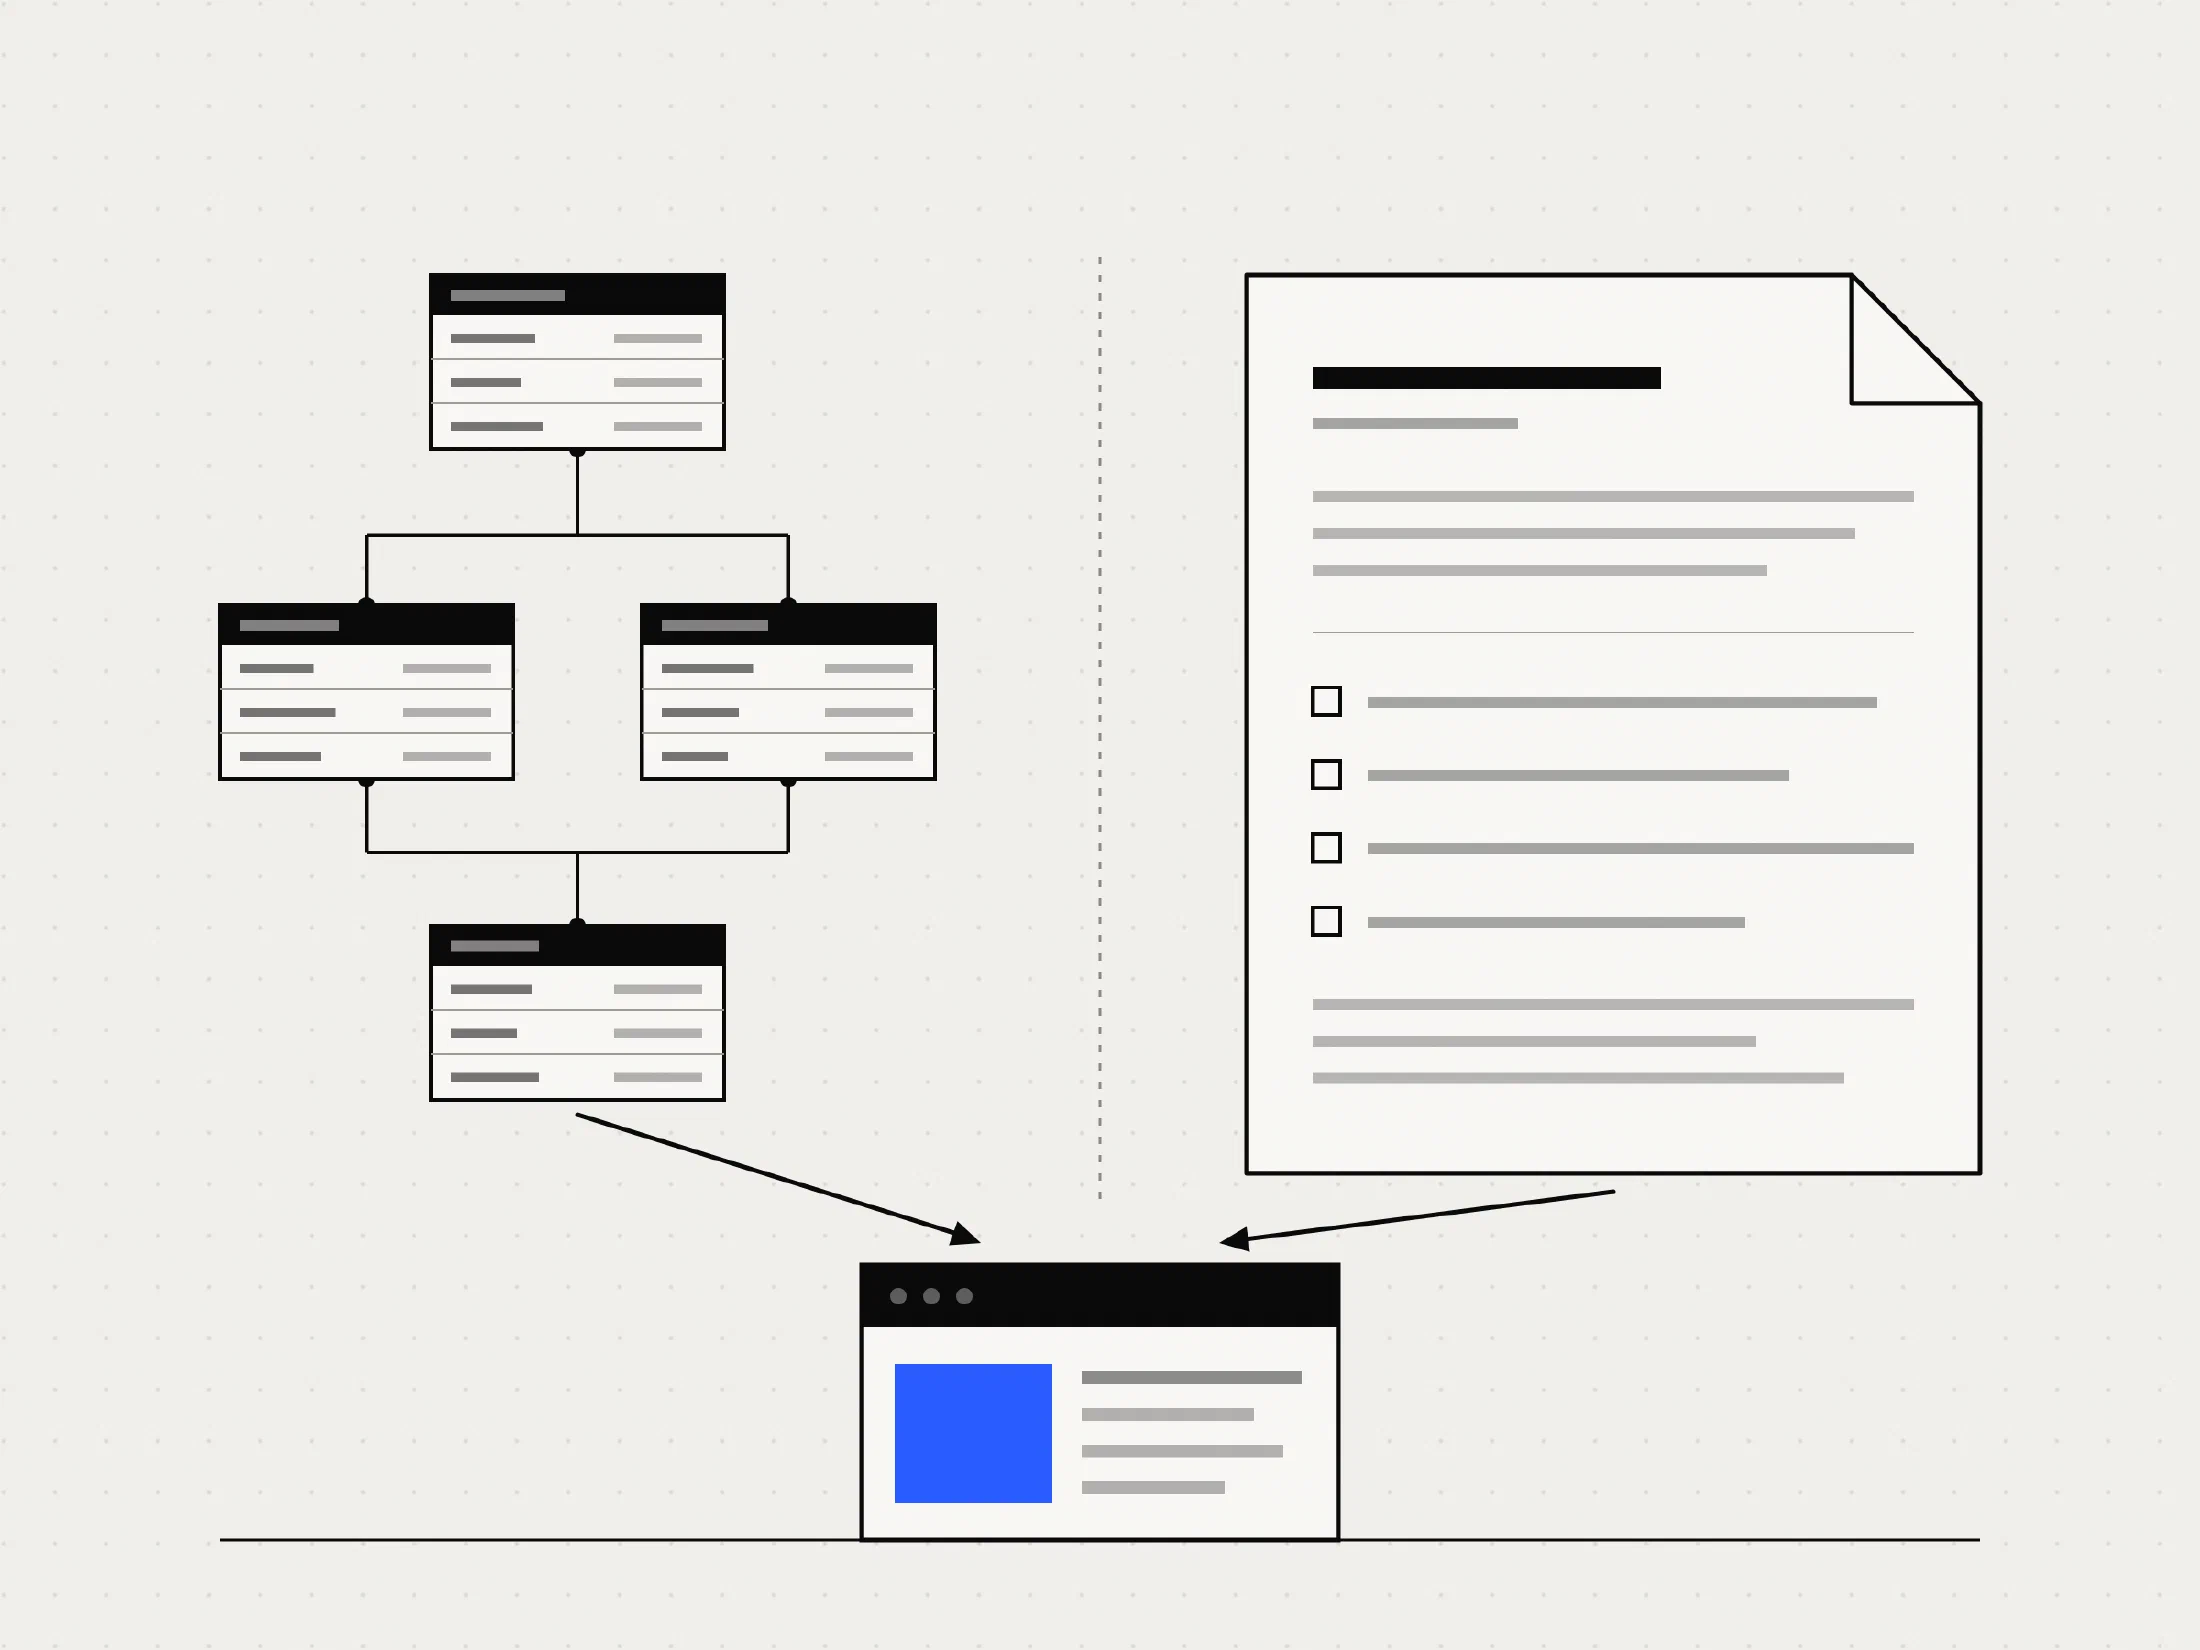
Le model-driven development (MDD) est le plus ancien des deux. Vous décrivez d’abord ce qu’est votre système dans un modèle formel : quelles données existent, par quelles étapes passe un dossier, quelles règles s’appliquent. L’application est déduite automatiquement de ce modèle. Le modèle est l’artefact principal, le code en est un dérivé. Dans les années 2000, l’idée a largement échoué ; pourquoi elle revient à l’ère de l’IA, nous l’avons expliqué dans cet article précédent.
Qu’est-ce que le spec-driven development ?
Le spec-driven development (SDD) est une méthode de l’ère de l’IA, connue grâce à des outils comme Kiro et GitHub Spec Kit. L’idée : avant qu’un agent IA n’écrive la moindre ligne de code, vous consignez dans un document structuré ce qui doit être construit. Exigences, choix de conception, tâches, en langue courante et le plus souvent simplement en Markdown. Cette spécification est la source de vérité : l’IA construit à partir d’elle, et vous comparez le résultat avec elle.
La différence en trois points
Les deux disent la même chose : le code n’est pas l’artefact principal, mais le dérivé de quelque chose de plus abstrait. La différence tient en trois choses.
L’artefact. Pour le MDD, un modèle formel ; pour le SDD, un document en langage naturel.
Le générateur. Avec le MDD, le code est déduit de façon déterministe : le même modèle donne toujours la même application. Avec le SDD, une IA interprète la spécification. C’est plus rapide et plus souple, mais l’exactitude n’est pas garantie.
Le point fort. Un modèle est sans ambiguïté mais rigide : il saisit parfaitement la structure et mal les exceptions. Une spécification est souple mais floue : elle saisit bien l’intention, mais laisse de la place à l’interprétation.
Les derniers vingt pour cent
Le MDD classique a échoué dans les années 2000 précisément sur ces exceptions. Le modèle générait sans problème les écrans, les données et les flux standard, mais pour les derniers vingt pour cent, le « oui, mais chez ce client-là ça se passe autrement », il fallait plonger à la main dans le code généré. Et à partir de ce moment-là, le modèle mentait.
Le SDD semble fait pour combler ce manque : ce qui ne rentre pas dans le modèle, vous l’écrivez en texte et l’IA le complète. De la structure là où c’est possible, de la langue courante là où c’est nécessaire.
Soyons honnêtes : ce n’est pas une baguette magique. Ce qui est difficile à modéliser est souvent aussi difficile à écrire sans ambiguïté. Et une IA qui interprète un texte peut se tromper subtilement. Sans tests qui découlent directement de la spécification, vous n’avez pas de méthode, juste du vibe coding avec une préface coûteuse. En plus, vous avez soudain deux sources de vérité (le modèle et le texte), qui peuvent diverger si vous ne fixez pas de règles claires.
Comment nous les combinons
Chez Tandem Studio, nous partons du parcours utilisateur : le chemin qu’un client, un dossier ou une commande suit dans votre entreprise. Nous traduisons ce parcours en event model, un schéma de tous les événements de votre processus, construit sur l’event sourcing avec DCB. Ce modèle porte la structure : quels événements existent, quelles données leur appartiennent, quelles règles doivent être garanties en même temps.
Chaque étape de ce schéma s’accompagne d’exemples concrets : étant donné ces événements antérieurs, quand cette action a lieu, alors on attend ce résultat. Ces exemples ne sont pas de la documentation qui vieillit. Ils deviennent tels quels les tests auxquels le logiciel construit doit satisfaire.
Et ce qui ne se laisse pas saisir dans un schéma (pourquoi une règle existe, ce qui doit se passer dans un cas limite, comment un écran se comporte pendant que le système traite) nous l’écrivons sous forme d’un court bloc de texte attaché à cette étape précise. Avec deux règles maison. Un : le texte est rattaché au modèle, pas dans un document séparé à côté. Deux : le texte ne peut pas inventer de nouvelle structure. S’il a besoin d’une donnée qui n’est pas dans le modèle, c’est d’abord le modèle qui change. Le modèle est la vérité sur la structure ; le texte est la vérité sur le sens.
Pour l’IA, chaque étape devient ainsi une petite tâche vérifiable : construis ce morceau, dans ce modèle, en respectant ces exemples. Le modèle garde les limites, les exemples prouvent le résultat.
En bref
Le model-driven development apporte de la structure, mais il échouait autrefois sur les exceptions. Le spec-driven development capte les exceptions, mais à lui seul il n’a aucun garde-fou. La combinaison d’un modèle formel comme squelette, de la langue courante comme tissu conjonctif et d’exemples qui deviennent des tests vous donne un logiciel qui reste lisible et qui correspond à ce que vous vouliez.
D’abord le modèle, puis la spécification, et seulement ensuite le code. Jamais l’inverse.
Curieux de voir à quoi ressemblerait un tel event model pour votre processus ? Parlez-nous-en, nous le dessinerons volontiers avec vous.