« Ça marchait parfaitement quand on en a fait la démonstration. »
C’est à peu près la phrase qu’on entend le plus dans les projets d’IA. En général, elle arrive trois mois après la livraison. La démo s’est bien passée, les dix premières factures ont été correctement comptabilisées, puis quelque chose se glisse dans le processus sans que personne ne le remarque.
C’est d’ailleurs la particularité des logiciels d’IA : ils échouent en silence. Un logiciel classique plante, affiche un message d’erreur ou s’arrête tout simplement. Un modèle de langage donne toujours une réponse, et cette réponse sonne aussi convaincante qu’elle soit juste ou non. Une facture mal comptabilisée ressemble exactement à une facture correcte, jusqu’à ce que quelqu’un se mette à chercher au moment de la déclaration de TVA.
C’est pourquoi, avec l’IA, tester n’est pas un bonus à la fin. C’est la seule chose qui fait la différence entre savoir et espérer que tout se passe bien.
Pourquoi vous ne pouvez pas y échapper
Trois raisons, de la plus pratique à la plus juridique.
Sinon, vous ne savez pas si vous progressez. Quelqu’un modifie un prompt pour régler une réclamation. Cette modification fonctionne-t-elle ? Probablement, pour ce cas-là. Mais qu’a-t-elle cassé ailleurs ? Sans mesure, chaque modification est un pari, et après dix modifications, plus personne ne sait où vous en êtes.
Le modèle sous vos pieds change. Les fournisseurs sortent de nouvelles versions, les anciennes sont retirées. Un nouveau modèle qui obtient de meilleurs scores sur tous les benchmarks peut faire moins bien sur votre tâche précise, parce que votre prompt était en partie ajusté à l’ancien modèle. C’est normal, mais vous voulez le savoir avant votre client.
Et depuis cet été, c’est aussi dans la loi. Nous y revenons plus bas.
Commencez par la distinction qui détermine tout
Avant de mesurer quoi que ce soit, séparez votre tâche en deux types.
Les tâches avec une seule bonne réponse. Le montant d’une facture, un numéro de TVA, le bon compte comptable, une classification. Ici, la qualité se mesure tout simplement : c’est juste ou pas.
Les tâches sans réponse unique. Un résumé, une réponse du support, un e-mail. Il n’existe pas une seule version correcte, mais il existe des versions clairement fausses.
L’erreur que nous voyons le plus souvent : tout ranger dans la seconde catégorie (« l’IA, c’est difficile à mesurer, c’est comme ça ») alors que la plus grande partie du travail se trouve généralement dans la première, et se mesure donc parfaitement. Cette distinction explique aussi pourquoi certains processus se prêtent mieux que d’autres à l’automatisation. Nous en avons déjà parlé dans quand l’IA n’est pas la solution.
Le golden set : ennuyeux, et la chose la plus importante que vous construirez
Le cœur de tout, c’est un ensemble fixe de cas de test, avec le résultat attendu pour chacun.
Concrètement : cinquante à deux cents vrais cas tirés de la pratique, vérifiés à la main. Pas d’exemples inventés, car il leur manque justement le désordre qui fait échouer les choses dans la réalité : des scans de travers, des avoirs, des fournisseurs étrangers, un client qui entasse trois questions dans un seul message. Environ soixante pour cent de cas normaux, quarante pour cent de cas limites.
Cet étiquetage représente quelques jours de travail fastidieux. C’est aussi le meilleur investissement de tout le projet. Un prompt se réécrit en un après-midi, mais un jeu de test vérifié ne se reconstruit pas comme ça.
Une règle le garde vivant : chaque erreur en production devient un cas de test. Votre jeu de test grandit naturellement avec la réalité, et au bout d’un an, il vaut plus que le code qui l’entoure.
Placez-le avec votre code dans le gestionnaire de versions. Le prompt, la version du modèle et le jeu de test vont ensemble dans un même commit, pour que vous puissiez toujours retrouver plus tard ce qui tournait exactement quand un résultat donné a été obtenu.
Mesurez deux chiffres, pas une « exactitude »
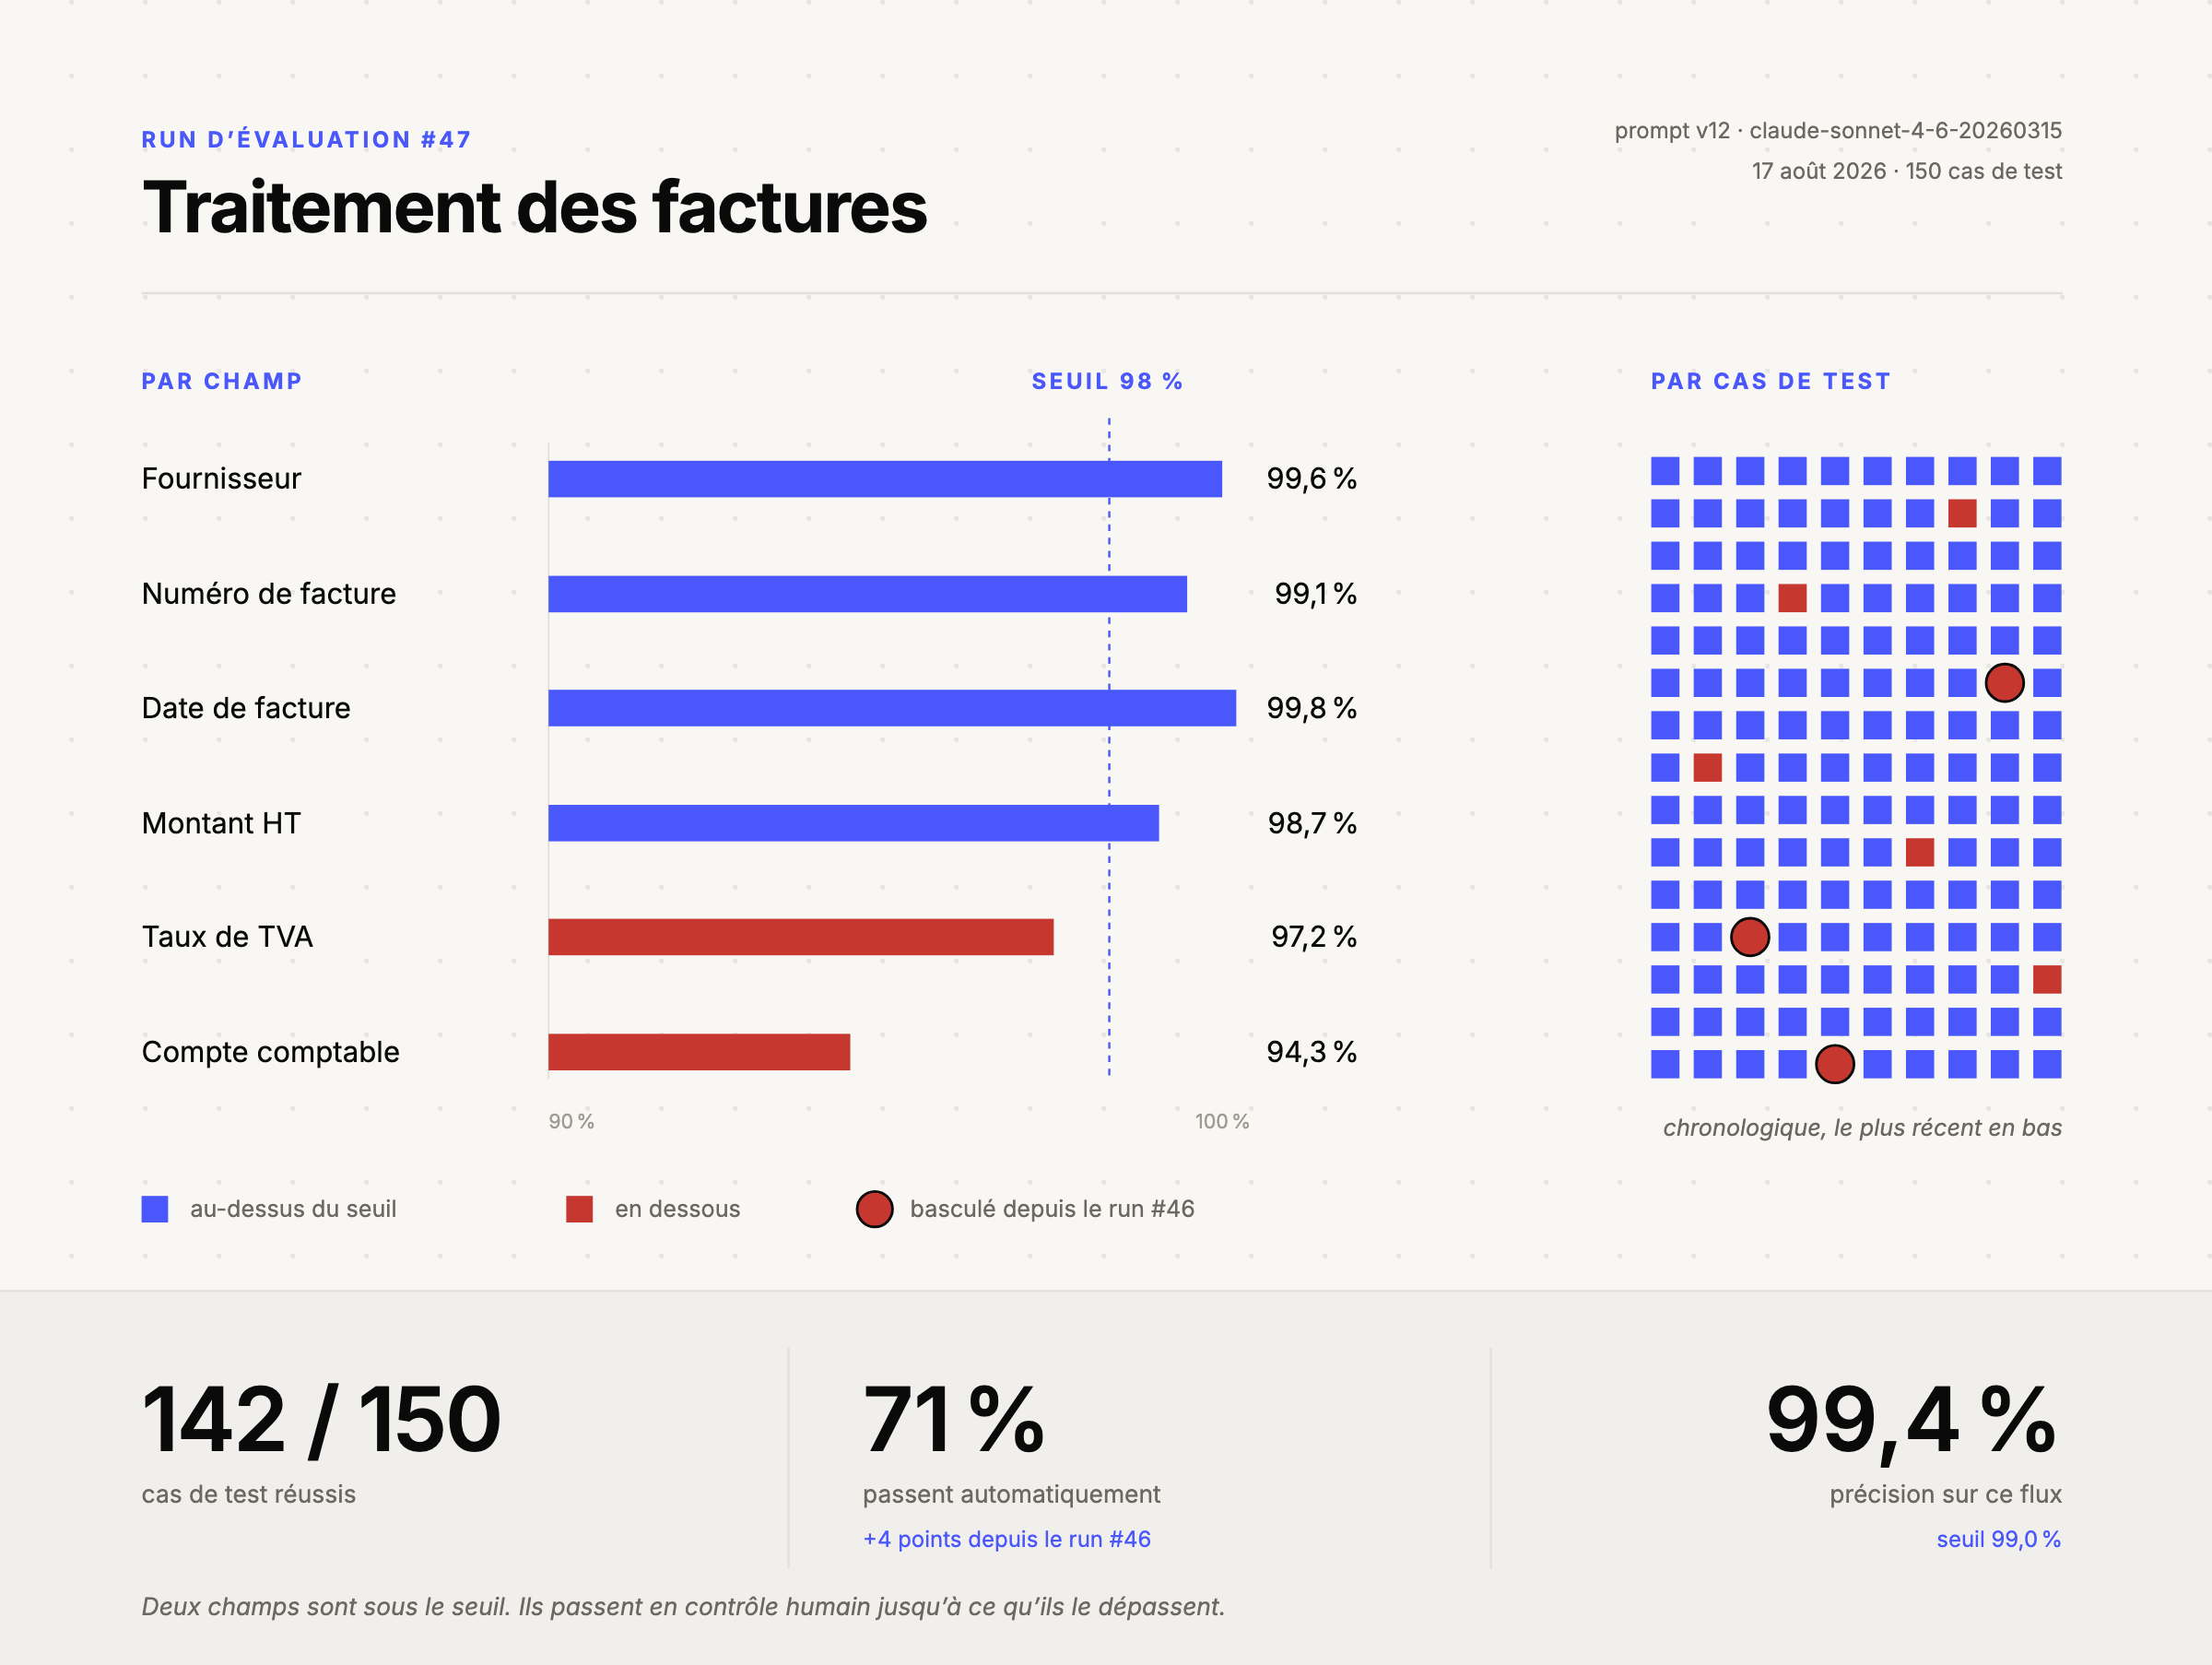
Pour quelque chose comme le traitement des factures, deux chiffres comptent, et ils tirent en sens inverse :
- Taux d’automatisation : la part qui passe sans intervention humaine.
- Précision sur ce flux : la part de celle-ci qui est réellement correcte.
Un service comptable accepte volontiers que soixante-dix pour cent des factures passent automatiquement si presque toutes sont justes. Il n’accepte jamais que quatre-vingt-quinze pour cent passent avec huit pour cent d’erreurs, car une seule facture mal comptabilisée coûte plus de temps que dix que vous traitez vous-même.
En pratique, cela veut dire : laissez le système indiquer, champ par champ, à quel point il est sûr de lui, et envoyez tout ce qui est sous le seuil à une personne. Vous réglez alors ce seuil sur votre jeu de test, au lieu d’espérer. Pour le traitement de documents, nous avons déjà décrit cette approche plus en détail dans traiter des documents avec l’IA.
Pour un support par chat, l’équivalent est le suivant : combien de conversations sont résolues sans escalade, face au nombre de fois où le bot affirme quelque chose de faux ou sort de son périmètre.
Ce que l’AI Act attend de vous
Les obligations qui pèsent précisément sur vous dépendent de votre rôle et de votre catégorie de risque. Nous l’avons détaillé dans L’AI Act : quel impact pour les PME ?. Ici, nous nous limitons à la partie qui concerne les tests, car sur ce point la loi est remarquablement concrète.
Pour les systèmes à haut risque (pensez aux logiciels qui trient des CV ou évaluent la solvabilité), les tests figurent noir sur blanc dans le texte. L’article 9 du règlement sur l’IA demande de tester au regard d’indicateurs et de seuils définis préalablement. L’article 15 demande d’indiquer dans la notice d’utilisation le niveau d’exactitude atteint et les indicateurs utilisés. Ces obligations s’appliquent à partir du 2 décembre 2027.
Relisez bien ce passage : définis préalablement. Vous fixez ce que vous jugez acceptable, puis vous mesurez. Pas l’inverse.
Autrement dit : ce qui relève simplement de la bonne ingénierie constitue aussi, pour les systèmes à haut risque, vos éléments de preuve. Si vous mettez en place une évaluation solide dès maintenant, vous n’aurez plus tard qu’à mettre par écrit ce que vous faites déjà. Sinon, vous recommencerez l’étiquetage en 2027.
Et si vous construisez un chatbot, une règle s’applique de toute façon depuis le 2 août 2026, quelle que soit la catégorie de risque : il doit indiquer clairement qu’il est une IA. L’exception prévue pour les cas où c’est évident est étroite. Un bot de service client qui converse avec aisance n’en relève pas. La Commission européenne a publié des lignes directrices (en anglais) à ce sujet, et le texte de l’article 50 est en ligne.
Et le RGPD s’applique en parallèle. L’article 22 reste pleinement valable : pas de décision fondée exclusivement sur un traitement automatisé et produisant un effet important sur une personne. Il faut un humain dans la boucle qui puisse réellement s’écarter de la proposition, pas quelqu’un qui clique sur « approuver ».
Notre approche
Chaque projet d’IA que nous livrons s’accompagne d’une suite de tests. En pratique, cela signifie :
- Construire ensemble le golden set à partir des vraies données du client, y compris les cas dont il sait qu’ils sont délicats.
- Fixer les seuils à l’avance et les dater, par champ ou par critère.
- Intégrer l’évaluation au pipeline, pour que chaque modification d’un prompt ou d’un modèle soit automatiquement mesurée, avec un aperçu des cas qui ont basculé. Pas seulement la moyenne. Une modification qui en gagne cinq et en perd quatre ressemble, dans la moyenne, à un progrès.
- Figer la version du modèle sur un snapshot exact, jamais sur un alias qui change en silence.
- Lors d’un changement de modèle, tourner d’abord en mode fantôme sur des données réelles, sans utiliser la sortie, puis déployer progressivement, avec la possibilité de revenir en arrière.
- Réinjecter les corrections des utilisateurs dans le jeu de test. Quand un comptable modifie une écriture proposée, c’est du matériel de test gratuit et déjà vérifié.
Nous utilisons pour cela des outils que vous pouvez faire tourner vous-même, sur des serveurs européens. Cela correspond à notre façon de tout construire : pas de dépendance à un fournisseur, le client garde son code, ses données et son infrastructure.
Si vous commenciez demain
Prenez cinquante vrais cas. Étiquetez-les à la main. Écrivez un script qui calcule la justesse champ par champ, et faites en sorte qu’il tourne automatiquement à chaque modification.
Rien que cela vous place devant la plupart des mises en œuvre d’IA que nous croisons sur le terrain. Le reste se construit par-dessus, et s’inscrit parfaitement dans l’approche que nous recommandons de toute façon : commencer petit, voir grand.
Une mise en œuvre d’IA sans jeu de test n’est pas une mise en œuvre. C’est une démo qui se trouve par hasard en production.
Vous avez une IA en place dont vous n’êtes plus sûr qu’elle fait ce qu’elle doit faire ? Ou vous voulez en mettre une en place que vous pourrez réellement suivre ? Contactez-nous, nous regarderons volontiers la question avec vous.
Cet article est une information générale, pas un conseil juridique. Pour une évaluation concrète de vos obligations au titre de l’AI Act, nous vous conseillons d’en parler avec un juriste.