Des factures papier que quelqu’un ressaisit. Des contrats en PDF que plus personne ne retrouve. Des bons de commande dans la boîte mail, encodés à la main dans l’ERP. Cela reste l’une des plus grandes pertes de temps dans les PME, et en même temps l’une des plus faciles à traiter aujourd’hui avec l’IA.
Dans cet article : comment le traitement de documents par l’IA fonctionne vraiment (pas la version marketing), quel retour sur investissement il apporte en général, et où sont les pièges. C’est une application concrète de ce que nous décrivions dans l’IA en entreprise : commencer petit, voir grand. Pour beaucoup de PME, le traitement de documents est justement ce genre de premier cas d’usage qui apporte vite de la valeur, sans devoir chambouler toute l’organisation.
Ce que « traiter des documents avec l’IA » veut vraiment dire
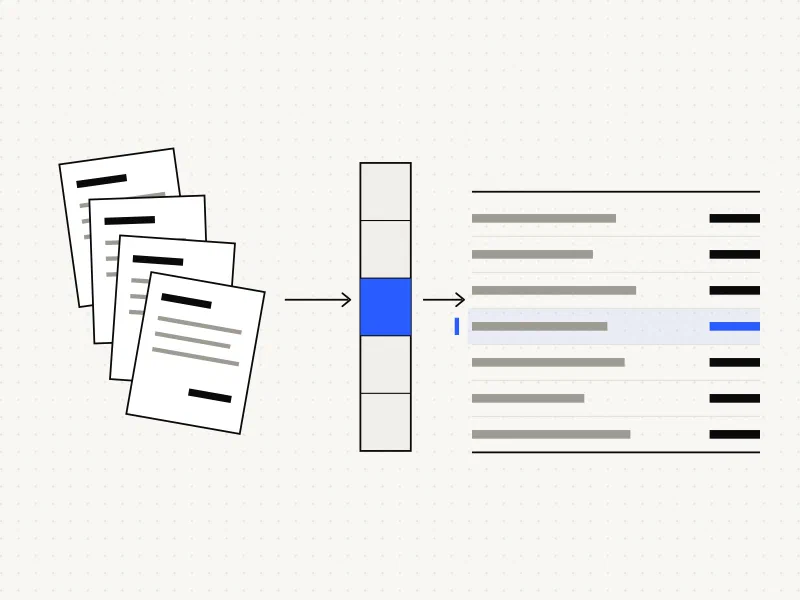
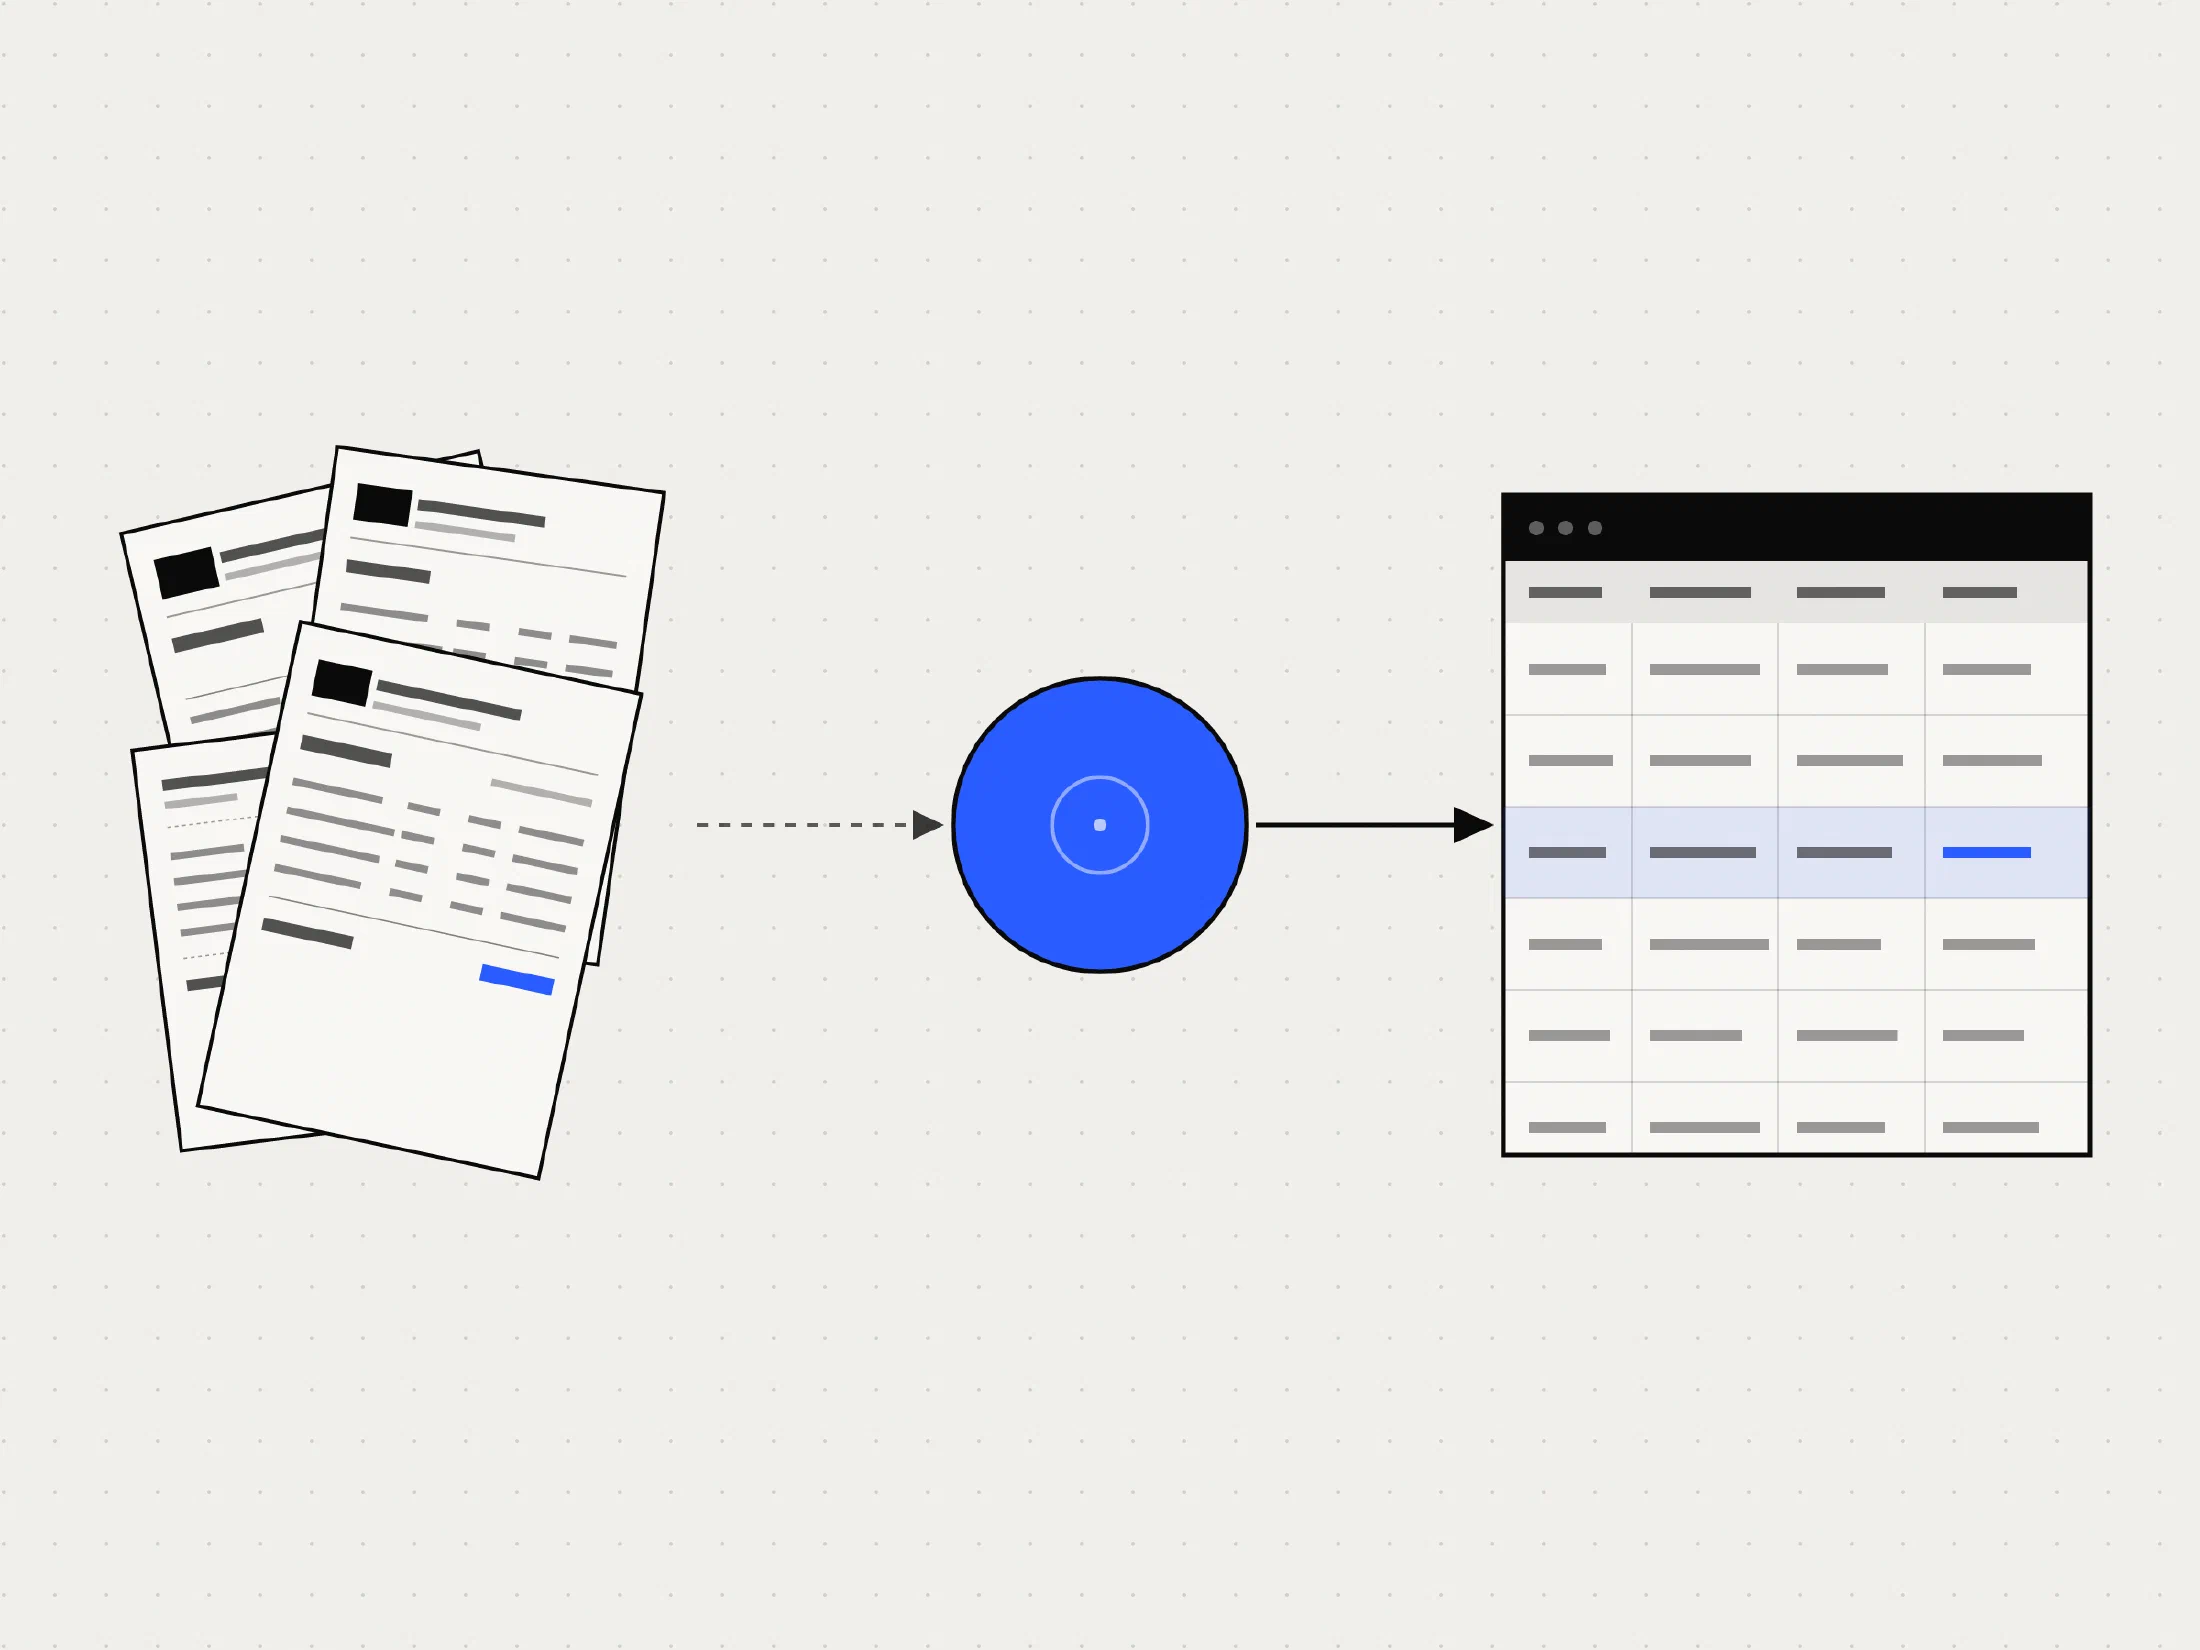
Le processus compte trois étapes, et il est important de bien les distinguer :
1. L’OCR (reconnaissance optique de caractères). Transformer une image ou un PDF en texte lisible par un ordinateur. Cela existe depuis des décennies. Une bonne OCR fonctionne aujourd’hui presque parfaitement, y compris sur des documents scannés ou photographiés.
2. L’extraction. Tirer de ce texte les bons champs : nom du fournisseur, numéro de facture, date, montant par ligne, TVA, total. C’est là que l’IA fait une énorme différence par rapport aux solutions classiques.
3. L’intégration. Envoyer les données structurées vers votre comptabilité, votre ERP ou tout autre outil, avec si besoin une étape de contrôle humain entre les deux.
L’ancienne méthode (avant les LLM) reposait sur des modèles rigides. Pour chaque fournisseur, quelqu’un devait indiquer où se trouvait le numéro de facture, où se trouvait la date, et ainsi de suite. Cela marchait très bien tant que le fournisseur ne changeait jamais sa mise en page, ce qui en pratique arrivait rarement.
La nouvelle méthode s’appuie sur des modèles de langage qui comprennent simplement ce qu’est une facture. Ils trouvent le numéro de facture où qu’il soit : en haut à gauche, en pied de page, dans un tableau, sous la forme « invoice number », « facture n° » ou « F-2024-00342 ». Toute la différence est là.
Pour quels documents cela fonctionne-t-il ?
Réponse courte : presque tous. Ce que nous voyons le plus en pratique :
- Factures entrantes : de loin le cas d’usage le plus courant, avec un retour sur investissement direct
- Bons de commande et confirmations de commande : surtout dans le commerce de gros et l’industrie
- Contrats : extraction des parties, des dates, des délais, des montants
- CV et candidatures : mise en forme structurée pour les outils RH
- Relevés bancaires : rapprochement avec la comptabilité
- Documents douaniers : déclarations et lettres de voiture (CMR, documents T, …)
- Polices d’assurance : extraction des garanties et des conditions
- Comptes rendus médicaux : pour les dossiers patients, avec des exigences RGPD strictes (voir notre article Faut-il tenir compte du RGPD dans une PME ?)
- Cahiers des charges et devis : comparaison entre fournisseurs
Si un document contient des informations structurées que vous ressaisissez aujourd’hui à la main, c’est un candidat.
Quelle est la précision réelle ?
C’est la question sur laquelle on est sceptique, à juste titre. La réponse honnête : pour les documents standard (factures, bons de commande, relevés bancaires), les bons modèles dépassent aujourd’hui 95 % de précision au niveau du champ. Mistral OCR annonce par exemple 94,89 % en général et jusqu’à 99,02 % pour les documents multilingues. Pour quelques champs très courants (numéro de facture, montant total), des pipelines d’extraction bien réglés approchent les 99 % de précision.
Mais 95 %, ce n’est pas 100 %. Une bonne mise en œuvre repose donc sur trois choses :
Le score de confiance. Le système indique pour chaque champ à quel point il est sûr. Une extraction sûre à 99 % passe automatiquement. Une autre à 70 % est montrée à une personne.
Les règles de validation. Le total de la facture doit être égal à la somme des lignes. La TVA doit correspondre au taux. Le numéro de fournisseur doit exister dans votre système. Chaque règle qui échoue déclenche une vérification.
L’humain dans la boucle. Pour les exceptions, un écran permet à quelqu’un de confirmer ou de corriger rapidement. Ces corrections apprennent au système pour la fois suivante.
Le résultat n’est pas « l’IA fait tout », mais « l’IA traite 80 à 89 % des documents de façon entièrement autonome » (un chiffre que les meilleures équipes de comptabilité fournisseurs atteignent aujourd’hui). Pour le reste, quelqu’un y passe trois secondes au lieu de trois minutes.
Combien ça coûte ?
Grand malentendu : beaucoup pensent qu’il faut acheter un outil à plusieurs dizaines de milliers d’euros par an pour traiter des documents. C’était vrai. Plus maintenant.
Le coût variable du traitement par l’IA est aujourd’hui très bas. Quelques chiffres concrets :
- Mistral OCR 3 (français, hébergé en Europe) : 2 $ pour 1 000 pages en standard, 1 $ pour 1 000 pages en inférence par lots. Soit environ 0,001 à 0,002 € par page.
- Claude ou GPT-4 avec vision : plus cher à cause des tokens d’image, typiquement 0,01 à 0,05 € par page pour l’OCR et l’extraction combinées.
- Notre propre OCR, auto-hébergée sur une infrastructure européenne : pour l’étape d’OCR (l’extraction du texte du PDF ou du scan), nous avons construit nos propres modèles. Ils ramènent le coût de cette étape presque à la seule puissance de calcul. L’extraction des champs dans un format structuré passe ensuite toujours par un modèle de langage (typiquement Mistral). Ce coût-là ne disparaît pas, mais celui de l’OCR, si.
Pour une PME typique qui reçoit 500 factures par mois, on parle donc de 5 à 50 € par mois de coûts d’IA variables, selon le modèle choisi. Comparez cela au coût manuel moyen de 12 à 23 $ par facture, et la différence saute aux yeux.
Le vrai coût est dans la mise en œuvre : la mise en place du flux de travail, l’intégration avec votre système existant, les règles de validation et l’écran de vérification. C’est typiquement un investissement unique de quelques milliers à quelques dizaines de milliers d’euros, selon la complexité.
Règle empirique pour le retour sur investissement : si votre équipe passe aujourd’hui au moins 10 heures par mois à ressaisir des documents, la mise en œuvre est remboursée en moins d’un an.
Où sont les pièges ?
Trois points d’attention.
La qualité des données à la source. Si vos fournisseurs envoient leurs factures en photos prises de loin, même la meilleure OCR a du mal. Dans ce cas, le premier investissement consiste souvent à demander aux fournisseurs d’envoyer des PDF plutôt que des scans. Petit effort, grande différence.
Les cas limites. Chaque entreprise a quelques documents bizarres : le fournisseur qui facture encore en espagnol, celui qui a une numérotation unique, le PDF qui contient en réalité deux factures. Une bonne mise en œuvre en tient compte, mais ils méritent une attention particulière.
Amplifier de mauvais processus. Si votre processus d’approbation des factures est chaotique aujourd’hui, l’IA ne va pas le résoudre. Elle va l’accélérer. L’IA est un amplificateur, pas une baguette magique. Le traitement de documents est assez simple pour que ce soit rarement un problème lors de l’extraction elle-même. Mais dès que vous le reliez à des flux d’approbation, mieux vaut d’abord y réfléchir sérieusement.
Conformité et hébergement : le choix européen
Les documents contiennent souvent des données personnelles, des informations sensibles pour l’entreprise ou des données bancaires. Si vous les faites traiter par un fournisseur d’IA, vous devez savoir où cela se passe et sous quel droit. Pour les entreprises qui ont des clients européens, ce n’est pas un détail : cela détermine quels fournisseurs vous pouvez utiliser et comment rédiger vos contrats de sous-traitance.
Notre choix par défaut : Mistral, l’entreprise française d’IA. Mistral tourne sur une infrastructure européenne, et peut en plus être auto-hébergé pour ceux qui ont de fortes exigences de conformité (santé, secteur financier, secteur public). En plus de Mistral OCR pour la reconnaissance de texte, nous utilisons aussi les modèles de fondation de Mistral pour l’extraction et la classification, au lieu de nous tourner par défaut vers des fournisseurs américains.
Pour certains cas d’usage où Mistral n’a pas encore le modèle le plus performant, nous pouvons utiliser Claude ou GPT-4 via des routes européennes, avec les bons contrats de sous-traitance. Mais chez nous, c’est l’exception, pas le point de départ. Tout le raisonnement derrière notre choix européen (juridique, opérationnel, financier) se trouve dans notre article Comment le cloud européen peut aider votre entreprise.
Quand le traitement de documents par l’IA a-t-il du sens pour vous ?
Nous regardons trois critères :
- Le volume : à partir d’environ 100 documents par mois, l’automatisation devient intéressante. En dessous, la mise en place coûte plus qu’elle ne rapporte.
- La structure : les documents doivent être un minimum structurés. Des factures, oui. Un patchwork de texte libre sans aucune logique, probablement pas.
- Le goulot d’étranglement : la ressaisie doit être aujourd’hui un vrai point de douleur. Si c’est moitié moins grave que vous ne le pensez, le retour sur investissement est limité.
Vous doutez que votre cas d’usage soit mûr pour l’IA ? Dans Quand l’IA n’est pas la solution, nous passons en revue cinq situations où notre conseil est « pas encore » ou « pas de cette manière ». Utile aussi pour peser le pour et le contre du traitement de documents.
Comment nous l’abordons chez Tandem
Notre stack standard pour le traitement de documents :
- Mistral comme fournisseur d’IA par défaut. Européen, compatible RGPD, bien placé en prix, sous le prix du marché des alternatives américaines. Pour les clients aux exigences les plus strictes sur leurs données, nous pouvons auto-héberger les modèles Mistral sur une infrastructure européenne.
- Nos propres modèles d’OCR pour la reconnaissance de texte. Pour les clients qui traitent de gros volumes d’un seul type de document (p. ex. uniquement des factures entrantes, uniquement des lettres de voiture CMR, ou un bon d’assurance précis), nous avons construit nos propres modèles d’OCR légers, qui extraient le texte du PDF ou du scan. Ce n’est que la première étape : l’extraction des champs dans un format structuré est ensuite faite par un modèle de langage (typiquement Mistral). Mais l’étape d’OCR elle-même, qui pèse généralement le plus lourd par page dans le coût variable chez les fournisseurs externes, devient nettement moins chère. Pour les clients qui ont assez de volume, c’est souvent l’option la plus judicieuse, y compris pour le contrôle des données : pour la reconnaissance de texte, aucune page ne quitte notre infrastructure européenne.
- Hébergement chez Scaleway. Les applications de nos clients tournent par défaut en France ou aux Pays-Bas, sous droit européen. Pas de surprise dans les contrats de sous-traitance (DPA), pas de question sur le risque lié au CLOUD Act.
- Validation et humain dans la boucle intégrés. Chaque extraction reçoit un score de confiance, chaque règle métier (total = somme des lignes, TVA correcte, fournisseur connu) est vérifiée avant que les données n’entrent dans votre système. Ce qui ne passe pas le contrôle arrive sur un écran de vérification où quelqu’un peut confirmer ou corriger en quelques secondes.
- Intégration avec vos outils existants. Nous nous connectons au logiciel comptable, à l’ERP ou au CRM que vous utilisez déjà. Pas de dépendance à un fournisseur, et rien à maintenir en parallèle.
Un projet typique se déroule ainsi : deux à trois semaines pour faire fonctionner le premier cas d’usage (le plus souvent les factures entrantes), puis une période de test avec de vrais documents et des retours, et ensuite l’extension à d’autres types de documents.
Prêt à automatiser le traitement de vos documents ?
Nous regardons volontiers avec vous quels documents vous prennent le plus de temps, et si l’automatisation a déjà du sens aujourd’hui. Parfois, la réponse est : oui, nous pouvons tourner d’ici six semaines. Parfois, c’est : d’abord mettre un peu d’ordre dans la façon dont les fournisseurs envoient leurs documents, et seulement ensuite automatiser. Parfois, un modèle d’OCR léger et sur mesure est le bon choix ; parfois, Mistral tel quel suffit. Les deux conviennent. Tout dépend du volume, du type de document et de ce que votre environnement technique permet.
Prenez rendez-vous pour un premier échange sans engagement.
Sources
Tous les chiffres et caractéristiques ont été consultés en mai 2026. Les prix de l’IA et les benchmarks de précision évoluent vite ; vérifiez la source pour les chiffres les plus récents.
Modèles d’IA pour le traitement de documents :
- Mistral OCR, page produit et chiffres de précision : mistral.ai/news/mistral-ocr
- Mistral OCR 3, tarification la plus récente : mistral.ai/news/mistral-ocr-3
- Mistral OCR via Google Cloud Vertex AI (europe-west4) : docs.cloud.google.com/vertex-ai/generative-ai/docs/partner-models/mistral/mistral-ocr
Benchmarks et études de précision :
- AIMultiple, Invoice OCR Benchmark, comparaison de LLM et d’outils spécialisés : research.aimultiple.com/invoice-ocr
- Businessware Technologies, AI Models Invoice Processing Benchmark : businesswaretech.com/blog/research-ai-models-invoice-processing-benchmark
- Parseur, AI Invoice Processing Benchmarks 2026 : parseur.com/blog/ai-invoice-processing-benchmarks
Coûts du traitement manuel :
- Quadient, coût par facture en manuel et en automatique (chiffre de 99 % de précision) : quadient.com
- Enterprise Imaging Systems / Institute of Finance & Management, 10 à 15 £ par facture en manuel : enterpriseimagingsystems.com/the-hidden-cost-of-manual-invoice-processing